2024-12-02 04:56:11
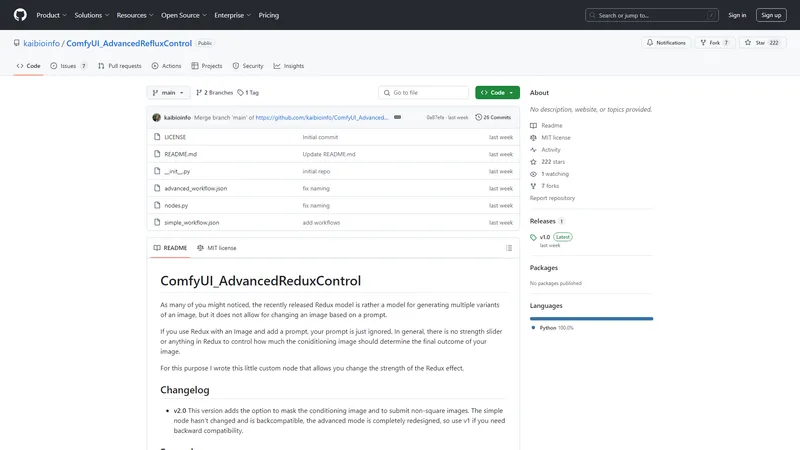
ComfyUI AdvancedRefluxControl
Categories
Generador de Fotos e Imágenes AIHerramientas para Desarrolladores AIImagen a ImagenMejorador de Imágenes AI
Users of this tool
Desarrolladores de software interesados en la generación de imágenesArtistas digitales que utilizan modelos de IA para crear arteInvestigadores en el campo de la inteligencia artificial y el aprendizaje automáticoEmpresas que buscan personalizar y mejorar la generación de contenido visualEstudiantes y académicos interesados en la aplicación práctica de modelos de IA
PricingType
Free

ComfyUI_AdvancedRefluxControl es una herramienta avanzada diseñada para mejorar la generación de imágenes utilizando el modelo Redux. Este proyecto permite a los usuarios controlar la fuerza del efecto Redux en la generación de imágenes, lo que es especialmente útil cuando se desea modificar una imagen basada en un prompt sin que este último sea ignorado. Con esta herramienta, los usuarios pueden ajustar la influencia de la imagen de condicionamiento en el resultado final, ofreciendo una mayor flexibilidad y control sobre la generación de imágenes. Además, la versión 2.0 introduce nuevas características como el enmascaramiento de la imagen de condicionamiento y el soporte para imágenes no cuadradas, lo que amplía aún más las posibilidades de personalización. Este proyecto es ideal para aquellos que buscan un mayor control y precisión en la generación de imágenes utilizando el modelo Redux.

Top Features

  1. Control avanzado de la fuerza del efecto Redux en la generación de imágenes
  2. Soporte para enmascaramiento de la imagen de condicionamiento
  3. Compatibilidad con imágenes no cuadradas
  4. Opciones de interpolación para ajustar la influencia de la imagen de condicionamiento
  5. Facilidad de uso con flujos de trabajo simples y avanzados

Simple Definition of Usecases

  1. Generación de variantes de imágenes con un control preciso sobre el efecto Redux
  2. Creación de arte digital utilizando prompts específicos sin que sean ignorados
  3. Investigación y desarrollo de nuevas técnicas de generación de imágenes con IA
  4. Personalización de contenido visual para empresas y marcas
  5. Educación y capacitación en el uso de modelos de IA para la generación de imágenes

Frequently Asked Questions

Q:

¿Cómo puedo controlar la fuerza del efecto Redux en la generación de imágenes?

A:

Puedes controlar la fuerza del efecto Redux utilizando el nodo avanzado y ajustando el factor de submuestreo. Valores más altos reducen la influencia de la imagen de condicionamiento.

Q:

¿Es posible utilizar imágenes no cuadradas con esta herramienta?

A:

Sí, la versión 2.0 introduce soporte para imágenes no cuadradas mediante la adición de bordes negros a la imagen para mantener la relación de aspecto.

Q:

¿Qué métodos de interpolación están disponibles para ajustar la influencia de la imagen de condicionamiento?

A:

Los métodos de interpolación disponibles incluyen 'área', 'bicúbica' y 'vecino más cercano', cada uno con diferentes efectos en la generación de imágenes.

Q:

¿Cómo puedo enmascarar la imagen de condicionamiento para afectar solo ciertas áreas de la imagen generada?

A:

Puedes enmascarar la imagen de condicionamiento utilizando la opción de enmascaramiento en el nodo avanzado. Esto te permite definir áreas específicas de la imagen que se verán afectadas por el efecto Redux.

Q:

¿Es posible combinar múltiples imágenes de condicionamiento para generar una sola imagen?

A:

Sí, puedes combinar múltiples imágenes de condicionamiento utilizando la herramienta y ajustando la influencia de cada imagen mediante el enmascaramiento y los factores de submuestreo.

Related AI Tools

VidRush AI - Vídeo, imagen y música con IA en un solo estudio creativo. | Top 4 AI Tool loading
VidRush AI llega para transformar la forma en que creadores, marcas y estudios entienden la producción de contenido digital. No se trata de un generador aislado, sino de una solución integral, lista para usar, que aúna en un mismo panel las tecnologías de inteligencia artificial más avanzadas para la creación de vídeo, imagen y música. La premisa es simple: si puedes imaginarlo, VidRush AI te ayuda a convertirlo en un resultado tangible y profesional. Esta plataforma ha sido construida para acompañar todo el flujo creativo, desde el primer trazo conceptual hasta el archivo final listo para publicar. Por eso, más que una herramienta, es un estudio digital de creación con un enfoque claro: democratizar el acceso a modelos de IA que antes parecían reservados a grandes estudios o a personas con conocimientos técnicos muy profundos. Posicionamiento del sitio web: VidRush AI no quiere ser una herramienta más dentro del saturado mercado de la IA generativa. Su posicionamiento se basa en la unificación, la velocidad y la calidad. Mientras que muchos creadores necesitan combinar varias aplicaciones para generar un vídeo, retocar una imagen y producir una canción, VidRush AI concentra toda esa potencia en un único espacio de trabajo. Esto permite que el creador no pierda tiempo saltando de pestaña en pestaña, ni duplique esfuerzos en exportaciones e importaciones. Hablamos de una posición estratégica muy valiosa para el público español y latinoamericano, donde la producción audiovisual de calidad ha sido tradicionalmente costosa y fragmentada. La plataforma se presenta como el punto de encuentro entre los grandes modelos de IA generativa, los flujos de trabajo profesionales y la facilidad de uso necesaria para que cualquier persona pueda aprovecharlos sin fricción. Su propuesta de valor es, ante todo, una invitación a trabajar de forma más eficiente, reuniendo capacidades que normalmente exigirían varias suscripciones y varios perfiles de usuario. Público objetivo: VidRush AI está pensado para un ecosistema de usuarios muy amplio. Por un lado, encontramos a los creadores de contenido de YouTube, TikTok e Instagram, que necesitan generar vídeos atractivos con una frecuencia alta y con una calidad visual que enganche a la audiencia. Por otro lado, están los especialistas en marketing digital y e-commerce, que necesitan producir anuncios, demostraciones de producto y contenido para redes sociales sin depender de un equipo de producción audiovisual. También es una herramienta muy valiosa para cineastas independientes, editores de vídeo y estudios de postproducción que buscan explorar nuevas estéticas, hacer previos rápidos o resolver tareas de reestilización. Los desarrolladores de videojuegos pueden encontrar en ella un aliado para generar concept art, animaciones de personajes y música ambiental. Y no podemos olvidar a los músicos, compositores y productores que desean crear maquetas, canciones completas o bandas sonoras con la ayuda de Suno AI. Por último, las agencias creativas y los profesionales freelance en España encontrarán una manera de optimizar sus flujos de trabajo y ofrecer resultados más ambiciosos a sus clientes, sin necesidad de ampliar plantilla ni de realizar grandes inversiones en hardware. Funciones principales: En el corazón de VidRush AI hay seis grandes grupos de herramientas. La primera es la generación de texto a vídeo, que convierte prompts descriptivos o guiones narrativos en vídeos cinematográficos con movimientos de cámara dinámicos, física realista y audio sincronizado. Este apartado utiliza modelos como Google Veo 3.1, Seedance 2.0 y Kling 3.0. La segunda es la función de imagen a vídeo, ideal para animar fotografías, ilustraciones o imágenes de producto. La plataforma es capaz de dotarlas de movimiento natural, iluminación coherente y estabilidad de personaje, gracias a Seedance 2.5, Veo 3.1 y Wan 2.6. La tercera es el vídeo a vídeo, una modalidad que permite reestilizar, transformar y extender clips ya existentes. Esta función abre un abanico de posibilidades creativas, como cambiar el estilo artístico de una grabación, replicar una coreografía o mantener la coherencia visual mediante referencias múltiples. En el terreno de la imagen, texto a imagen permite generar retratos fotorrealistas, ilustraciones, imágenes comerciales y concept art. Para ello cuenta con modelos como Nano Banana Pro, Seedream 5.0 y GPT Image 2. La función de imagen a imagen, por su parte, sirve para remezclar, ampliar o transformar imágenes, ofreciendo la posibilidad de cambiar una fotografía a estética anime, 3D o alta resolución sin perder la identidad del sujeto. Finalmente, el generador de música con IA, impulsado por Suno 5.5, Suno 5.0 y Suno 4.5, produce canciones con voz humana natural, instrumentación rica y rango dinámico completo. Todo ello se integra en una suite creativa única, diseñada para cubrir el ciclo completo de producción. Características de contenido: No basta con tener un generador potente si el usuario no tiene inspiración o no sabe cómo exprimirlo. Por eso, VidRush AI incorpora una sección de comunidad y exhibición, bautizada como Community & Showcase, donde se pueden ver creaciones reales realizadas con la plataforma. Este espacio funciona como una galería de referencia y como un punto de partida para entender las posibilidades de cada modelo. Ver ejemplos reales de texto a vídeo, imagen a vídeo, texto a imagen o música con IA ayuda a construir un repertorio mental de buenas prácticas. Además, el usuario puede explorar diferentes estilos, composiciones y atmósferas antes de lanzarse a generar sus propias piezas. Esta característica tiene un valor pedagógico enorme, porque democratiza el aprendizaje. En lugar de tener que seguir tutoriales externos, el propio showcase se convierte en una fuente constante de trucos y consejos visuales: qué tipo de prompt funciona mejor, cómo se ve la luz en un retrato generado, qué nivel de detalle se puede alcanzar con determinada resolución o cómo se comporta la física en un clip animado a partir de una imagen fija. Todo este contenido está pensado para que el usuario llegue a la plataforma con una idea clara y sepa, desde el primer minuto, qué puede esperar de ella. Experiencia de usuario: La experiencia de usuario es uno de los pilares de VidRush AI. Desde que se entra en la plataforma, la interfaz se presenta limpia, organizada y muy visual. No hace falta tener conocimientos de programación ni dominar ningún software complejo. El flujo de trabajo se estructura en cuatro pasos muy intuitivos. Primero se elige la herramienta o el modelo que se quiere utilizar dentro de las categorías de vídeo, imagen o música. Segundo, se introduce el prompt en lenguaje natural o se suben los archivos de referencia, ya sean fotografías, vídeos o clips de audio. Tercero, se configuran los parámetros de salida: aspecto de pantalla, duración, movimiento de cámara, estilo de letra o preferencias instrumentales. Y cuarto, se pulsa el botón de generar. En cuestión de minutos, el usuario puede visualizar el resultado en el propio espacio de trabajo, hacer variaciones si lo necesita y descargar la versión final en alta resolución. Esta estructura minimalista reduce la curva de aprendizaje hasta casi cero. Para un creador español que necesita ritmo constante de publicación, esto supone una ventaja enorme: menos fricción técnica y más tiempo para la parte creativa. El sistema también es ágil a la hora de iterar. Si una imagen no convence, se puede ajustar el prompt o cambiar de modelo sin empezar de cero. Si un vídeo necesita otro estilo, la opción de vídeo a vídeo permite rehacerlo sin volver a grabar nada. Y si una canción requiere un arreglo distinto, siempre se puede recurrir a Suno para generar una nueva variación. Características técnicas: Desde el punto de vista técnico, VidRush AI destaca por su integración directa con los modelos fundacionales más punteros del mercado. No hablamos de aproximaciones genéricas, sino de acceso real a Google Veo 3.1, Seedance 2.5, Kling 3.0, Wan 2.6, Nano Banana, Seedream, GPT Image 2 y Suno. Esta integración permite al usuario elegir en cada momento la herramienta que mejor se adapta a su proyecto, manteniendo la interfaz unificada. El resultado es una experiencia modular y muy flexible. También es importante señalar la apuesta por la velocidad. La plataforma utiliza clústeres de GPU distribuidos y de alto rendimiento para conseguir que las imágenes se rendericen en cuestión de segundos y que los vídeos cinematográficos completos se completen en menos de dos minutos. Esto no solo mejora la experiencia, sino que permite una iteración mucho más rápida en entornos profesionales. En cuanto a la calidad de salida, los usuarios pueden exportar sus vídeos en resoluciones de 720p, 1080p Full HD y hasta 4K, con formatos de aspecto que se adaptan a cada plataforma: 16:9 para YouTube, 9:16 para TikTok e Instagram Reels y 1:1 para publicaciones en redes sociales. Esta flexibilidad técnica convierte a VidRush AI en una herramienta muy práctica para campañas multicanal, donde el mismo contenido debe adaptarse a diferentes soportes sin perder calidad. Todo ello está respaldado por una promesa clara de derechos comerciales: el contenido generado bajo planes de pago o paquetes de créditos adquiridos incluye licencia comercial completa. Esto significa que se puede monetizar en YouTube, TikTok, anuncios de televisión, videojuegos, plataformas de streaming y proyectos de clientes. Experiencia para marcas y profesionales: La plataforma no solo es adecuada para creadores individuales. También ofrece un valor enorme para las marcas y las agencias que necesitan generar campañas publicitarias de forma rápida y económica. Por ejemplo, una marca de moda puede fotografiar una prenda y convertir esa foto en un vídeo dinámico donde la tela se mueve de forma natural. Una empresa tecnológica puede transformar una captura de pantalla en un demo animado para explicar el funcionamiento de una aplicación. Una agencia de viajes puede crear vídeos de destinos espectaculares a partir de textos descriptivos, sin necesidad de desplazar a un equipo de filmación. La inclusión del generador de música AI en el mismo flujo permite, además, producir la banda sonora de cada campaña sin recurrir a bancos de música genéricos ni a compositores caros. Este enfoque integrado cambia la economía de la creación de contenido. Las pequeñas y medianas empresas españolas pueden acceder a una capacidad creativa que antes estaba reservada a grandes presupuestos. Contenido generado por la comunidad: VidRush AI apuesta por la transparencia y por mostrar resultados reales. La sección de la comunidad incluye proyectos realizados por usuarios de todo el mundo, desde escenas urbanas de ciencia ficción hasta retratos cibernéticos, pasando por anuncios de comercio electrónico y mascotas con estética cinematográfica. Esta exposición pública de trabajos cumple varias funciones. Por una parte, funciona como validación social: demuestra que la plataforma produce resultados tangibles y de alta calidad. Por otra, actúa como fuente de inspiración: cada obra subida por la comunidad puede servir de punto de partida para una nueva creación o para experimentar con un estilo concreto. Además, ayuda a los nuevos usuarios a identificar qué modelo utilizar según el resultado que desean. Ver que una imagen futurista fue creada con Nano Banana Pro o que un clip realista de un camaleón se generó con Kling 3.0 permite entender rápidamente las fortalezas de cada tecnología. De este modo, el aprendizaje se vuelve orgánico y colaborativo. Modelos integrados y flexibilidad: Una de las grandes ventajas de VidRush AI es la posibilidad de seleccionar entre distintos modelos de IA para una misma tarea. No existe una única forma de hacer las cosas, y cada generador tiene su propia personalidad. Google Veo 3.1 es especialmente fuerte en vídeo cinematográfico con audio nativo sincronizado. Seedance 2.5 destaca por la consistencia de personajes y la referencia multimodal, lo que resulta muy útil para proyectos narrativos. Kling 3.0 es reconocido por su capacidad para representar el movimiento humano realista. Wan 2.6 ofrece movimientos de cámara muy cuidados y atmosféricos. En el terreno de la imagen, Nano Banana Pro brilla en iluminación fotorrealista y tonos de piel naturales, mientras que Seedream 5.0 es ideal para composiciones artísticas de altísimo detalle. GPT Image 2 aporta capacidades de razonamiento y maneja bien la tipografía compleja. Y Suno, en su versión 5.5, eleva la generación musical a un nivel de producción casi humana. Esta variedad no es una simple acumulación de etiquetas, sino una herramienta real de trabajo. El usuario principiante puede empezar con opciones rápidas y preestablecidas. El profesional puede profundizar y elegir el motor exacto que mejor se adapte al estilo visual o sonoro que necesita. Se trata, en definitiva, de una flexibilidad que fomenta la experimentación y el crecimiento de cada creador. Estrategia de monetización y precios: VidRush AI ofrece un modelo freemium que permite a los nuevos usuarios probar la plataforma con créditos gratuitos al registrarse. Esto es muy importante, porque reduce la barrera de entrada y permite comprobar la calidad del servicio sin asumir un riesgo económico inicial. A partir de ahí, el usuario puede decidir si quiere adquirir paquetes de créditos bajo demanda o suscribirse a un plan mensual con ventajas adicionales, como renderizado prioritario. La estructura de precios está pensada para adaptarse a diferentes niveles de uso. Un creador ocasional puede pagar solo por lo que consume, mientras que un estudio con alto volumen de trabajo puede beneficiarse de una suscripción que incluya una asignación mensual de créditos y un acceso más rápido a los servidores de generación. Además, VidRush AI suele lanzar promociones por tiempo limitado, como el descuento del 20% que aparece en el mensaje de bienvenida, para incentivar la actualización de cuenta o la contratación de planes anuales. Esta estrategia facilita que el usuario no se sienta atrapado por una suscripción demasiado rígida y pueda escalar su inversión a medida que crece su producción. Seguridad, derechos y tranquilidad: En el mundo de la IA generativa, una de las mayores preocupaciones es el uso legal de los resultados. VidRush AI responde a esta inquietud de forma clara: todos los contenidos creados en planes activos de pago o con paquetes de créditos comprados incluyen derechos de comercialización completos. Esto significa que el usuario puede utilizar las imágenes, vídeos y canciones en proyectos comerciales, anuncios, plataformas de streaming, videojuegos y campañas para clientes sin pagar royalties adicionales. Esta claridad jurídica es esencial para agencias, marcas y estudios que necesitan proteger su reputación y ofrecer a sus clientes garantías sobre la propiedad de los activos. También es relevante destacar que la plataforma incluye una capa de configuraciones de salida que permite alinear el contenido con las necesidades de cada publicación, ya sea un anuncio breve, un vídeo largo o una historia vertical. Este nivel de control, combinado con la velocidad de generación, convierte a VidRush AI en una opción segura y profesional para proyectos exigentes. Facilidad de integración en el flujo diario: La rutina de un creador de contenido no siempre es fácil. Hay plazos, reuniones, revisiones y mucha presión. Por eso, cualquier herramienta que se integre bien en el flujo de trabajo tiene ventaja. VidRush AI está diseñado para simplificar el proceso, no para complicarlo. No se necesitan equipos con tarjetas gráficas especiales ni conocimientos de renderizado. Todo el procesamiento se realiza en la nube, a través de GPU distribuidas. El usuario solo necesita una conexión a internet y un navegador. Esta ligereza operativa es especialmente valiosa para profesionales que trabajan sobre la marcha, con portátiles modestos o colaborando en equipo. Además, la plataforma permite descargar los archivos en alta resolución, listos para publicarse. El paso de la idea al producto final nunca ha sido tan directo. La propuesta de VidRush AI no es solo tecnológica; es también metodológica. Invita a pensar en la IA como un colaborador dentro de un proceso creativo más amplio, no como un sustituto del talento humano. El usuario sigue siendo el director, el diseñador, el compositor. La plataforma pone a su disposición una orquesta de modelos para que él la dirija. Impacto en la industria creativa española: En un mercado cada vez más globalizado, los creadores españoles necesitan competir con producciones de todo el mundo. Las plataformas de generación con IA pueden nivelar el terreno de juego y ofrecer oportunidades inéditas. VidRush AI, con su interfaz en español y su enfoque internacional, encaja perfectamente en esta nueva realidad. Un estudio de diseño en Madrid puede producir piezas audiovisuales para una marca de Barcelona sin necesidad de subcontratar costosas agencias de postproducción. Un músico independiente en Valencia puede generar la carátula de su próximo sencillo, crear un vídeo lírico y componer la maqueta de una canción completa, todo en la misma tarde. Una tienda de moda en Sevilla puede lanzar anuncios verticales con una calidad visual comparable a la de grandes campañas internacionales. Esta capacidad de creación aumenta la competitividad y permite a los profesionales españoles demostrar que la creatividad local puede viajar a cualquier parte del mundo. Conclusión: VidRush AI es mucho más que un generador de vídeo con IA; es una plataforma integral que reúne lo mejor de la generación de vídeo, imagen y música en un único ecosistema creativo. Para creadores de contenido, equipos de marketing, estudios de animación, diseñadores, músicos y cualquier persona con una idea, esta herramienta ofrece un camino directo hacia resultados profesionales. Su fortaleza reside en tres pilares fundamentales: la excelencia de los modelos integrados, la velocidad de los flujos de trabajo y la claridad de los derechos comerciales. Además, su experiencia de usuario es sencilla, práctica y pensada para inspirar, no para intimidar. Si estás buscando una forma de optimizar tu producción creativa, reducir tiempos de entrega y ampliar tu capacidad de experimentación, VidRush AI te tiende una mano. Empieza con los créditos gratuitos, explora el showcase, prueba la generación de texto a vídeo y descubre hasta dónde puede llegar tu imaginación. La revolución creativa ya está aquí, y se llama VidRush AI.
Generador de música de IA
Freemium
Pixal3D - Genera activos 3D fieles al píxel con texturas PBR listos para usar. | Top 4 AI Tool loading
Pixal3D es un sistema de generación de modelos 3D a partir de imágenes bidimensionales que combina lo mejor de la reconstrucción geométrica y la inteligencia artificial generativa. Este proyecto, desarrollado por investigadores de la Universidad de Tsinghua y TencentARC, ha sido aceptado en SIGGRAPH 2026, uno de los foros más prestigiosos en gráficos por computador, lo que confirma su solidez científica. Su propuesta es clara: en lugar de inventar la forma de un objeto desde una posición canónica y perder información de la imagen original, Pixal3D establece una correspondencia directa entre los píxeles de la imagen y el volumen tridimensional. Este mecanismo, llamado retroproyección de píxeles, permite crear activos con una fidelidad casi idéntica al concepto 2D. Para artistas, desarrolladores de videojuegos y profesionales del sector espacial, esto supone un cambio de paradigma. Por fin es posible obtener mallas de alta resolución con texturas PBR fieles, listas para usar en cualquier pipeline profesional, sin pasar por largas tareas de retopología, mapeado UV o pintado manual. El posicionamiento de Pixal3D dentro del ecosistema de herramientas de IA para 3D es muy claro: se sitúa en el extremo de la alta fidelidad visual. No intenta ser una herramienta de bocetado rápido que produce formas aproximadas; su objetivo es convertirse en la solución de referencia para quienes necesitan que el modelo final respete al máximo el diseño original. Frente a alternativas como Meshy AI u otros generadores basados en atención, Pixal3D evita las llamadas alucinaciones de IA en la vista principal. La marca se dirige tanto a usuarios técnicos como a creadores que quieren integrar la generación automática en sus flujos de producción. La página web presenta una narrativa de precisión, investigación avanzada y facilidad de uso. El término “listo para usar” aparece de forma natural, porque los archivos exportados en GLB contienen materiales estándar que pueden introducirse directamente en Unity, Unreal Engine o Blender. Además, el proyecto es de código abierto, lo que refuerza su posicionamiento como infraestructura confiable y auditable, no solo como un demo pasajero. La audiencia de Pixal3D es amplia pero especializada. En primer lugar, están los artistas técnicos y los concept artists que necesitan validar sus diseños en 3D sin alterar la intención original. En segundo lugar, los desarrolladores de videojuegos, especialmente estudios pequeños e independientes, encuentran en esta herramienta una forma eficiente de cubrir el catálogo de props, personajes y escenarios sin ampliar la plantilla. En tercer lugar, los creadores de contenido para realidad virtual, realidad aumentada y plataformas de metaverso necesitan prototipos rápidos y modelos con materiales correctos; Pixal3D les ofrece esa capacidad. En cuarto lugar, el público académico y científico puede estudiar el código, reproducir los experimentos y adaptar la arquitectura a nuevas investigaciones. Finalmente, los diseñadores de producto, los arquitectos y los estudios de animación también pueden beneficiarse, ya que la herramienta no se limita a objetos aislados: su síntesis modular de escenas permite reconstruir entornos completos y separados por objetos. Este amplio abanico de usuarios convierte a Pixal3D en un recurso muy práctico y versátil para el mercado hispanohablante, desde estudios independientes en Madrid hasta laboratorios de IA en Buenos Aires o México. Las características funcionales de Pixal3D son impresionantes. El sistema acepta una sola imagen como entrada, pero también puede aprovechar varias vistas para mejorar la consistencia 360 grados. Cuando se proporcionan múltiples fotografías de un personaje o una rotación completa de un objeto, el algoritmo agrega las distintas retroproyecciones mediante un mecanismo de multi-view aggregation. Este proceso rellena las zonas ocluidas y produce una topología más precisa. La generación de geometría utiliza un backbone llamado Trellis.2, una arquitectura de red neuronal optimizada para extraer características de forma rápida y escalable. Gracias a esto, se pueden crear mallas de alta resolución en tiempos muy reducidos. Además, cada modelo incluye texturas PBR, con mapas de color base, normales y rugosidad, que reaccionan correctamente a la luz dinámica en motores de juego. Esta texturación profesional es uno de los puntos clave que diferencia a Pixal3D de herramientas más sencillas que solo generan color por vértice. El resultado se exporta en formato GLB, un estándar universal que funciona en casi cualquier aplicación 3D. Toda la experiencia está pensada para ser intuitiva: se sube la imagen, se espera la generación y se descarga el archivo final. La automatización elimina horas de trabajo manual y reduce la barrera de entrada para creadores sin grandes conocimientos técnicos. El contenido ofrecido en el sitio web destaca por su claridad y su orientación a casos de uso reales. La página de inicio explica el proceso en cuatro pasos: subir la imagen, aplicar la retroproyección de píxeles, generar geometría y texturas, y descargar el activo GLB. Esta estructura es sencilla y fácil de seguir, incluso para quienes se acercan por primera vez a la generación 3D con IA. También se incluyen secciones dedicadas a responder las preguntas más frecuentes, mostrando qué hace Pixal3D, cómo se diferencia de otros generadores, si es posible usar varias imágenes, qué formatos produce y quién está detrás del proyecto. Los textos combinan un tono técnico con una explicación accesible, de modo que tanto un artista técnico como un estudiante pueden entender el valor de la herramienta. En la página también se enlazan recursos como el playground, la documentación de GitHub, los modelos de referencia y varias plantillas de otros sistemas como TRELLIS.2, Hunyuan3D, Hi3DGen, Direct3D-S2, Sparc3D, InstantMesh y Stable Fast 3D. Esta abundancia de material educativo convierte el sitio en una guía práctica para cualquiera que desee adentrarse en la generación procedural de activos. La experiencia de usuario en Pixal3D está diseñada para ser fluida y sin fricciones. Desde el primer momento, el visitante encuentra un llamado a la acción claro: “Probar gratis” o “Empezar gratis”. No es necesario registrarse ni instalar nada para probar la demo en el navegador, ya que existe una versión en Hugging Face que funciona con Gradio. Esto permite experimentar con la tecnología antes de decidir si se desea ejecutar el modelo localmente. El playground de la web carga una interfaz minimalista donde se puede arrastrar una imagen, ajustar opciones y lanzar la generación. Aunque la generación de modelos 3D requiere cierto tiempo de cálculo, el sistema informa claramente del estado del proceso. La página está traducida a varios idiomas, incluido el español, lo que facilita el acceso a una audiencia global. La documentación de GitHub incluye scripts de inferencia y explicaciones detalladas para quienes quieran integrar Pixal3D en su propio pipeline. Este nivel de accesibilidad es poco frecuente en herramientas de investigación tan avanzadas. La web también incorpora reseñas de usuarios, preguntas frecuentes y una sección de novedades. En conjunto, la experiencia comunica seriedad, transparencia y un profundo respeto por el tiempo del usuario. Desde el punto de vista técnico, Pixal3D es una obra sólida. La arquitectura se basa originalmente en el modelo Direct3D-S2, aunque la versión de código abierto más reciente ha evolucionado hacia Trellis.2, un backbone muy eficiente que reduce el costo de inferencia sin sacrificar la calidad. La retroproyección de píxeles se realiza a múltiples escalas, lo que permite capturar tanto los contornos generales como los microdetalles. Esto resuelve el problema de la correspondencia 2D-3D que afecta a los generadores convencionales. El sistema está pensado para ser escalable: puede funcionar con una sola imagen de referencia o con varias vistas; en este último caso, agrega los volúmenes retroproyectados y mejora la coherencia de la parte posterior del objeto, una de las debilidades habituales de la IA generativa. La textura PBR se genera directamente durante el proceso, lo que elimina la necesidad de herramientas adicionales. Los mapas de color, normal y rugosidad están alineados con la geometría, asegurando una integración perfecta en motores como Unity, Unreal y Blender. Además, el código abierto permite a los desarrolladores modificar la arquitectura, introducir nuevos módulos o entrenar con datos propios. Todo esto hace de Pixal3D una plataforma tan robusta que puede pasar de la investigación puntera a la producción profesional sin fricciones. Las ventajas competitivas de Pixal3D se aprecian especialmente en situaciones exigentes. Un estudio de animación que necesita capturar el diseño exacto de un personaje para una serie puede confiar en el sistema para generar la malla base con la silueta original. Un desarrollador de juegos independiente puede convertir rápidamente un boceto de un cofre, una espada o un vehículo en un modelo listo para usar en su prototipo. Un equipo de realidad virtual puede combinar varias imágenes de un objeto real y obtener una reconstrucción fiel con detalles que no aparecerían si se usara un generador genérico. Incluso los profesionales del diseño industrial pueden explorar variaciones de producto partiendo de renders 2D. Para investigadores, el código y los modelos abiertos facilitan la comparación con otros algoritmos y la reproducción de experimentos. La síntesis modular de escenas es otro diferenciador importante: en lugar de generar un único objeto, la herramienta puede analizar una imagen compleja, dividirla en elementos y generar una escena con objetos separados. Esto abre la puerta a la creación rápida de entornos virtuales completos, algo que tradicionalmente requería días o semanas de trabajo manual. En resumen, Pixal3D es mucho más que una demo académica: es una herramienta práctica, eficiente y lista para usar. Su excelencia técnica, su compromiso con el código abierto y su enfoque en la fidelidad visual la convierten en una opción obligada para cualquier profesional que trabaje con gráficos 3D. Tanto si eres un artista en solitario que busca ahorrar horas de modelado, como si lideras un equipo de desarrollo que necesita acelerar el pipeline, esta plataforma puede transformar la manera de trabajar. Si tu prioridad es que el resultado 3D se parezca de verdad a tu concepto 2D, Pixal3D es la respuesta. Su capacidad para generar geometría detallada, texturas PBR y escenas completas en cuestión de minutos redefine el estándar de calidad en la industria. Pruébalo gratis desde el navegador y descubre por qué artistas, investigadores y desarrolladores ya lo consideran el nuevo referente de la generación de activos 3D por IA.
Imagen a Modelo 3D
Free
Perchance AI Image Generator - Generador de imágenes con IA gratuito, sin registro y con múltiples modelos. | Top 4 AI Tool loading
Perchance AI Image Generator es una herramienta gratuita de generación de imágenes por inteligencia artificial, diseñada para convertir descripciones escritas en imágenes de alta calidad desde el propio navegador, sin necesidad de crear una cuenta, instalar programas ni superar muros de pago. La propuesta es directa: abrir el espacio de trabajo, escribir una indicación, elegir un modelo y descargar el resultado. Por eso es un servicio que se presenta como listo para usar desde el primer segundo, y que evita las fricciones habituales de muchas plataformas de IA generativa. El posicionamiento de Perchance AI Image Generator es muy claro: se dirige a personas que quieren generar imágenes a partir de texto sin pagar por créditos ni suscribirse a planes premium. Mientras que muchas herramientas de IA esconden sus funciones detrás de formularios de registro o sistemas de pago por uso, esta página integra todo el flujo de trabajo en la propia portada. El usuario llega, ve el panel de generación, escoge un modelo, escribe su prompt y obtiene la imagen en el mismo lugar. Ese enfoque minimalista lo convierte en una alternativa especialmente atractiva para quienes desean una experiencia rápida y sin compromisos. El público objetivo es amplio. Por un lado están los diseñadores gráficos y los ilustradores, que necesitan generar referencias visuales, estudiar estilos o crear bocetos antes de pasar a herramientas profesionales. Por otro lado, los creadores de contenido y los community managers encuentran en la plataforma una fuente inmediata de imágenes para redes sociales, portadas, historias o vídeos. También hay un hueco importante para estudiantes y docentes, que pueden explorar las capacidades de la IA generativa en entornos académicos sin preocuparse por el coste. Emprendedores, pequeñas startups y curiosos de la tecnología completan un ecosistema de usuarios que valoran sobre todo la facilidad de acceso. Las funciones principales de Perchance AI Image Generator están orientadas a que la generación sea práctica y eficiente. El espacio de trabajo permite escribir un prompt, seleccionar entre varios modelos de IA y ajustar la relación de aspecto. Dependiendo del modelo elegido, también es posible modificar los pasos de generación, la guía, la semilla e incluso usar un prompt negativo para evitar ciertos elementos. La capacidad de cambiar de modelo es uno de los puntos más interesantes: si un servicio público está saturado, el usuario simplemente elige otro motor y continúa su trabajo. Esa flexibilidad marca una diferencia clara frente a plataformas cerradas que dependen de un único proveedor. Desde el punto de vista del contenido, la web no se limita a mostrar un generador. Incorpora una sección de características, un tutorial breve, una explicación sobre cómo funciona el sistema y un apartado de preguntas frecuentes. Ese contenido ayuda a reducir la curva de aprendizaje y presenta consejos y trucos para obtener mejores resultados: describir el sujeto, el estilo, la iluminación y el estado de ánimo, usar chips de inspiración, ajustar la semilla o cambiar de modelo cuando algo falla. También incluye una política de límites transparente, basada en la realidad de los hosts públicos, y respuestas claras sobre el acceso directo, la privacidad y el uso responsable. La experiencia de usuario está pensada para que cualquier persona pueda empezar a crear en segundos. La página carga el generador en la parte superior, de modo que no hay que buscar entre menús. El flujo es simple: eliges el modelo, escribes la idea y pulsas generar. Si el modelo elegido está lento o devuelve un error, el propio sistema sugiere cambiar a otro. Esa facilidad para moverse entre opciones convierte una posible frustración en una solución inmediata. Además, la interfaz es ligera y ordenada, con los controles justos para no abrumar al usuario, pero con la profundidad suficiente para quienes quieren afinar el resultado. En el plano técnico, Perchance AI Image Generator funciona como un puente entre el navegador y varios hosts públicos de modelos de IA. Cuando el usuario envía su prompt, el espacio de trabajo empaqueta la configuración y solicita la imagen al modelo seleccionado. El resultado regresa al navegador para su vista previa y descarga. Este diseño permite ofrecer el servicio de forma gratuita y evita depender de una única infraestructura de GPU. La contrapartida es que la disponibilidad y la velocidad pueden variar, por lo que el acceso a varios modelos se convierte en una forma práctica de garantizar la continuidad en momentos de máxima demanda. En cuanto a los casos de uso, la herramienta brilla en múltiples escenarios. Un community manager puede crear ilustraciones originales para una campaña en redes sociales sin tener que contratar a un ilustrador. Un concepto artist puede experimentar con distintos motores para encontrar la estética adecuada antes de empezar un proyecto serio. Una startup puede generar mockups de producto para una presentación interna o para validar una idea con inversores. En entornos educativos, sirve para demostrar el funcionamiento de la IA generativa y enseñar a los alumnos a estructurar prompts. Para creadores de vídeo, es una fuente rápida de fondos y texturas que pueden integrarse en proyectos audiovisuales. La transparencia es otro de sus valores diferenciales. La página no promete generaciones ilimitadas de forma engañosa, sino que explica que los límites provienen de los hosts públicos y recomienda cambiar de modelo cuando se producen colas. Tampoco vende un plan Pro ni intenta presionar al usuario para que pague. Esa honestidad genera confianza, algo poco habitual en un mercado lleno de herramientas con pruebas gratuitas que terminan en suscripciones obligatorias. Para quien busca una solución ágil, gratuita y lista para usar, esta plataforma representa una opción excelente. La calidad de las imágenes depende en gran medida del modelo elegido y de la claridad del prompt. Z Image Turbo, FLUX, Stable Diffusion y Qwen Image ofrecen interpretaciones diferentes, y precisamente esa variedad enriquece la experiencia. El usuario aprende rápido que no existe un único modelo superior, sino que cada uno tiene fortalezas distintas. Algunos son más rápidos, otros tienen mejor acabado estético y otros ofrecen un realismo más marcado. Poder compararlos en un mismo panel convierte la herramienta en un pequeño laboratorio creativo en el que se puede experimentar sin límites económicos. En resumen, Perchance AI Image Generator es una alternativa muy recomendable para cualquiera que quiera crear imágenes mediante IA de forma rápida y sin complicaciones. Su enfoque multiplataforma, su ausencia de registro y su política de precios completamente gratuita la convierten en una opción única dentro del panorama actual. Para usuarios que buscan una herramienta simple y fácil de usar, y que además quieren reducir el tiempo entre la idea y el resultado visual, este generador aporta un valor enorme. La documentación integrada, el tutorial y las respuestas a las dudas más frecuentes refuerzan su utilidad como recurso de aprendizaje y producción. El futuro de este tipo de servicios pasa por la inmediatez y la flexibilidad, y Perchance AI Image Generator ya ofrece ambas cosas. No necesita instalación, no exige datos personales y permite que cualquier persona, tenga o no experiencia en diseño, pueda expresar visualmente una idea. Su filosofía es clara: si un modelo falla, prueba otro; si una imagen no te convence, ajusta el prompt y vuelve a intentarlo. Esa actitud convierte la incertidumbre técnica en una oportunidad para explorar y mejorar. Para muchos usuarios, esta plataforma será la puerta de entrada al fascinante mundo de la generación de imágenes por inteligencia artificial.
Texto a Imagen
Free
Pony Diffusion - Imágenes impresionantes con IA: Pony Diffusion V6 XL para tu creatividad. | Top 4 AI Tool loading
Pony Diffusion es mucho más que un simple generador de imágenes: es una herramienta lista para usar que ha sabido ocupar un espacio propio dentro del ecosistema de la inteligencia artificial generativa. Su propuesta es clara: a partir de una descripción textual, cualquier persona puede obtener ilustraciones de estilo pony, fantasía y animación de una forma directa, sin necesidad de tener conocimientos avanzados de programación. Este modelo de difusión de texto a imagen, con su versión V6 XL, se ha consolidado como un recurso muy popular entre quienes buscan una alternativa más eficiente que los generadores genéricos, gracias a su especialización, su comunidad activa y su enfoque en la calidad estética. El sitio web actúa como puerta de entrada a este universo creativo. No solo presenta el modelo, sino que ofrece un playground en línea donde se puede probar la herramienta al instante, una galería con ejemplos visuales, explicaciones sobre su funcionamiento, enlaces a redes sociales y una sección de preguntas frecuentes. El conjunto configura una experiencia pensada para que el nuevo usuario se sienta acompañado desde el primer clic. La información está organizada de manera clara, con un lenguaje directo que evita tecnicismos innecesarios. Para el público hispanohablante, esto resulta especialmente valioso, porque convierte un modelo de IA, a menudo percibido como complejo, en una solución práctica y accesible. En términos de posicionamiento, Pony Diffusion no compite por ser el modelo de imágenes más generalista del mercado. Su posicionamiento es mucho más concreto: es la opción preferida para quienes desean crear arte con estética pony o estilos afines, como personajes antropomórficos, escenas de fantasía y retratos con un acabado no fotorrealista. Esta especialización es, paradójicamente, su mayor fortaleza. Al estar afinado con aproximadamente 80.000 imágenes de ponis de alta calidad, el modelo comprende mejor las convenciones visuales, las proporciones, los colores y las atmósferas que busca este tipo de público. Por eso, frente a alternativas generalistas, ofrece resultados con una coherencia estética notable y una mayor fidelidad a la petición del usuario. El público objetivo de Pony Diffusion es amplio y variado. Por un lado, están los artistas digitales e ilustradores que emplean la IA como apoyo para explorar ideas, generar conceptos o crear piezas acabadas. Por otro, se encuentran los aficionados a la cultura pony y brony, que encuentran aquí una manera de materializar personajes e historias propias. También hay creadores de contenido para redes sociales, diseñadores gráficos, desarrolladores que desean integrar generación de imágenes en sus proyectos y educadores que utilizan la herramienta como material didáctico para enseñar fundamentos de inteligencia artificial y arte digital. Esta diversidad de usuarios se refleja en las discusiones comunitarias y en los distintos casos de uso que se documentan dentro y fuera del sitio. Una de las grandes bazas de Pony Diffusion es su facilidad de uso. El playground en línea permite escribir un prompt y obtener una imagen en segundos, lo que reduce la fricción que suele asociarse a otros modelos de IA. No hace falta instalar dependencias, configurar entornos ni disponer de un equipo potente; todo sucede en el navegador. Esto convierte a la herramienta en algo más eficiente para la exploración creativa, sobre todo en las primeras fases de un proyecto. En lugar de preocuparse por la infraestructura técnica, el usuario puede centrarse en lo esencial: la idea que quiere transmitir, la composición, la iluminación y el estilo. Al terminar, el resultado se puede guardar y utilizar en otros programas de edición, lo que facilita la integración en flujos de trabajo profesionales. Las características técnicas del modelo también merecen atención. Pony Diffusion se basa en una arquitectura de difusión latente y ha sido afinado con un conjunto de datos de aproximadamente 80.000 pares de texto e imagen, seleccionados principalmente para contenido seguro y sugestivo, evitando material explícito. Durante el entrenamiento se emplea CLIP para realizar un ranking estético de las imágenes, lo que ayuda al modelo a aprender qué produce una composición visualmente atractiva. Además, el sistema permite usar etiquetas como score_9 para indicar el nivel de calidad deseado en el resultado. Estos detalles técnicos, aunque pueden pasar desapercibidos para el usuario novel, explican por qué las imágenes generadas suelen tener un equilibrio cromático y una definición superiores a la media de los modelos generalistas. La comprensión de cómo funciona el modelo es otro punto que la web trata con claridad. La sección How Pony Diffusion Works explica las cuatro etapas fundamentales: generación de texto a imagen, afinamiento con datos de alta calidad, uso de CLIP para la evaluación estética y mecanismos de puntuación. Este enfoque divulgativo ayuda a que el usuario entienda no solo cómo usar la herramienta, sino por qué se obtienen ciertos resultados. Para quienes desean profundizar, la página enlaza también a recursos externos como Hugging Face, donde se puede acceder al código, al modelo y a la documentación técnica. De este modo, la web cumple una doble función: ser un escaparate sencillo para principiantes y una puerta de acceso a un ecosistema técnico más amplio. El modelo fomenta además una comunidad vibrante. Las menciones en X antes Twitter y las colaboraciones con plataformas como PixAI demuestran que Pony Diffusion no es un proyecto aislado, sino parte de una conversación más amplia sobre la creación de imágenes con IA. Los usuarios comparten generaciones, proponen mejoras, publican tutoriales y contribuyen al desarrollo del modelo. El sitio recoge algunos de estos tweets y anima a participar en discusiones. Este entorno colaborativo ofrece un valor añadido difícil de cuantificar: cuando alguien se queda atascado con un prompt, la comunidad suele responder con ejemplos, sugerencias y ajustes. Así, el aprendizaje se convierte en una experiencia compartida, más gratificante y también más eficaz. Desde el punto de vista de la experiencia de usuario, destaca la claridad visual de la página. La galería de ejemplos permite hacerse una idea inmediata del estilo de imágenes que puede producir Pony Diffusion. Cada ejemplo está acompañado de la descripción que lo generó, lo que sirve como fuente de inspiración y como mini tutorial de prompts. Esta característica es muy útil para usuarios noveles, que a menudo no saben cómo formular sus peticiones. Ver una imagen de una chica pony pelirroja en un campo de flores y leer el prompt correspondiente ayuda a entender qué tipo de lenguaje utiliza el modelo. En este sentido, la web actúa como una guía visual integrada, una buena manera de reducir la curva de aprendizaje y de animar a la experimentación. La licencia de acceso abierto es otro de los pilares del proyecto. La CreativeML OpenRAIL-M permite que cualquier persona pueda usar, modificar y redistribuir el modelo, siempre que respete las condiciones establecidas. Esto abre la puerta a usos comerciales, académicos y creativos muy diversos. Para una pequeña empresa o un autónomo, poder entrenar un modelo derivado a partir de Pony Diffusion es una ventaja enorme: no hay que partir de cero, sino que se parte de un modelo que ya contiene una sólida base estética. Para los investigadores, por su parte, supone la oportunidad de analizar el proceso de afinamiento y compararlo con otras arquitecturas. La transparencia del proyecto refuerza la confianza de la comunidad y fomenta un ecosistema de innovación abierta. En el plano práctico, la web incluye una sección de preguntas frecuentes muy completa, que resuelve las dudas más habituales: qué es Pony Diffusion, cómo funciona, para qué se puede usar, si es gratuito, cuáles son sus datos de entrenamiento, cómo mejorar la calidad de las imágenes, si se puede usar comercialmente y qué recursos hay disponibles. Esta sección es un reflejo de la filosofía del proyecto: hacer que la tecnología sea comprensible y accesible. Las respuestas son breves, directas y están pensadas para resolver problemas concretos. No se trata de un manual interminable, sino de una guía práctica que atiende las necesidades reales de los usuarios y que, además, mejora el posicionamiento SEO de la página. En cuanto a la relación con otros productos, la página incluye una referencia a Pollo AI, una herramienta que promete transformar ideas en imágenes y vídeos de alta resolución. Esta colaboración permite ampliar las posibilidades del usuario, que puede pasar de generar una imagen en Pony Diffusion a producir contenido animado en otra plataforma. La presencia de enlaces externos, como Top AI Tools o directorios de herramientas de IA, también facilita que nuevos usuarios descubran el proyecto. Este tejido de alianzas confirma que Pony Diffusion no solo es un modelo técnico, sino un nodo dentro de un ecosistema más amplio de creación asistida por inteligencia artificial. La evolución del proyecto es otro aspecto que los usuarios siguen con interés. Los tweets que se muestran en la página mencionan una futura versión, Pony Diffusion V7, y actualizaciones relacionadas con SD3. Esto indica que el equipo detrás del modelo no se detiene y sigue explorando nuevas arquitecturas y técnicas. Para la comunidad, esta sensación de progreso continuo es muy motivadora. Saber que las herramientas que utilizan se actualizarán y mejorarán con el tiempo les anima a invertir tiempo en aprender sus flujos de trabajo. Al mismo tiempo, la retroalimentación de los usuarios influye en el desarrollo, creando un ciclo de mejora constante del que se benefician todos. No se puede hablar de Pony Diffusion sin mencionar la dimensión artística. A diferencia de otros generadores centrados en el fotorrealismo, Pony Diffusion abraza lo no fotorrealista con naturalidad. Esto abre un espacio creativo muy amplio, donde la imaginación manda. Las imágenes resultantes tienen un carácter casi ilustrativo, con colores vibrantes y líneas que recuerdan al cómic o la animación. Los usuarios pueden jugar con estilos, encuadres, vestuarios y ambientaciones sin las limitaciones de la realidad. Es un lienzo digital en el que las palabras se convierten en color y forma. Para los amantes del arte conceptual, los diseñadores de juegos o los escritores que buscan visualizar a sus personajes, esta libertad es un recurso invaluable. Por último, conviene subrayar la importancia de que la herramienta sea gratuita. En un mercado donde muchas soluciones de IA han apostado por modelos de suscripción, Pony Diffusion mantiene un acceso abierto que democratiza la creatividad. No es necesario pagar para probar el modelo ni para obtener resultados de alta calidad. Esto reduce las barreras de entrada y permite que estudiantes, aficionados o profesionales con presupuestos limitados puedan experimentar sin miedo. El próximo paso natural, en muchos casos, será explorar el modelo en profundidad, contribuir a la comunidad o incluso crear derivados comerciales. La gratuidad, combinada con una buena experiencia de usuario, es una de las razones por las que Pony Diffusion ha logrado fidelizar a una base de usuarios tan amplia y entusiasta. En conclusión, Pony Diffusion se presenta como una propuesta sólida y bien definida dentro del panorama de la IA generativa. Su especialización en imágenes de estilo pony y su carácter no fotorrealista le otorgan una ventaja competitiva clara. La web que lo presenta cumple con eficacia su misión de informar, guiar y facilitar el acceso a la herramienta. La combinación de modelo abierto, comunidad comprometida, recursos didácticos y un playground accesible hace que cualquier persona pueda dar sus primeros pasos en la generación de imágenes IA sin frustraciones. Para quien busque una herramienta lista para usar, más eficiente en contextos creativos específicos, centrada en lo esencial y con una comunidad activa detrás, Pony Diffusion es, sin duda, una opción que merece la pena explorar.
Texto a Imagen
Free
Meme Picture - Generador gratuito de memes con tu cara en segundos | Top 4 AI Tool loading
MP Meme Picture es una plataforma en línea que convierte tus fotos en memes personalizados de forma casi inmediata. Su propuesta central es tan simple como poderosa: sube una selfie o una foto de tu mascota, elige una de las plantillas clásicas y deja que la inteligencia artificial coloque tu cara en el meme. No necesitas registrarte, no necesitas tarjeta de crédito y no necesitas conocimientos de diseño. Todo el flujo está pensado para que cualquier persona, desde un estudiante hasta un community manager, pueda crear una imagen lista para usar en cuestión de segundos y compartirla en WhatsApp, Discord, Telegram, iMessage o redes sociales. Posicionamiento del sitio web Frente a herramientas como Imgflip o Canva, que destacan por la superposición de texto sobre imágenes de stock, Meme Picture se centra en una necesidad específica: poner tu cara en memes clásicos. Esta especialización le permite ofrecer un flujo más eficiente y un resultado más natural que los editores genéricos. La promesa de privacidad —la eliminación de la foto original justo después de la generación— refuerza un posicionamiento de confianza. Además, la versión gratuita con tres generaciones diarias sin registro invita a probar el servicio sin fricción, mientras que los planes Pro y los packs permanentes ofrecen más candidatos, exportación HD, GIF y sin marca de agua. Público objetivo El público principal está formado por usuarios de chats de grupo y redes sociales que desean reaccionar con humor propio. También se incluyen creadores de contenido que publican memes con regularidad, equipos de marketing que buscan piezas visuales rápidas, estudiantes y profesores que quieren explicar ideas con humor, padres y madres que comparten fotos familiares, y amantes de las mascotas que quieren convertir a sus animales en protagonistas de memes. La ausencia de registro y la compatibilidad móvil amplían el alcance a usuarios sin experiencia técnica. Funciones principales Meme Picture ofrece quince plantillas clásicas: Distracted Boyfriend, Woman Yelling at Cat, Drake Hotline Bling, Surprised Pikachu, This Is Fine, Change My Mind, One Does Not Simply, Success Kid, Hide the Pain Harold, Stonks, Expanding Brain, Two Buttons, Unsettled Tom, Doge y Grumpy Cat. Cada plantilla mantiene la composición icónica que los usuarios reconocen de internet. El generador permite subir fotos en JPEG, PNG o WebP de hasta 4 MB; las imágenes grandes se comprimen automáticamente. Hay estilos visuales automáticos, cartoon, pixel art, dibujo a mano y realista. Se pueden añadir subtítulos y, si se desea, instrucciones adicionales para afinar el resultado. Cada ejecución produce entre dos y cuatro candidatos en unos treinta segundos. Después se descarga un PNG optimizado para compartir. Contenido y experiencia de usuario La página de inicio está diseñada para reducir la curva de aprendizaje. El flujo en tres pasos —tu foto, elige plantilla, descarga y comparte— es directo y práctico. La interfaz muestra una vista previa de las plantillas, ejemplos de subtítulos y una sección de preguntas frecuentes que responde a las dudas habituales. Existen páginas dedicadas por plantilla con historia, pies de foto y preguntas frecuentes, lo que facilita la elección. La experiencia es coherente en móvil y escritorio: se puede arrastrar un archivo o tocar para subir. El hecho de no pedir registro hasta que el usuario desee guardar historial o usar Pro elimina barreras. La generación se realiza en la misma página, sin saltos innecesarios. Para quienes buscan mejorar sus resultados, hay consejos y trucos dispersos en las descripciones, como usar una selfie clara o una foto de mascota bien iluminada. Características técnicas El sistema está impulsado por GPT Image 2, aunque Meme Picture es independiente y no está afiliado a OpenAI. El procesamiento de imágenes es automatizado: detecta el rostro, lo recorta, lo integra en la plantilla y aplica el estilo elegido. La compresión automática de imágenes grandes ayuda a mantener tiempos de respuesta breves. El borrado de la foto original inmediatamente después de la generación es una función relevante de privacidad; solo los usuarios registrados conservan las imágenes finales. La plataforma no entrena ni vende las fotos, según su propia información. La versión Pro incluye exportación en alta definición, generación de memes GIF e historial en la nube. Los packs permanentes permiten comprar generaciones que no caducan y se consumen únicamente tras agotar la cuota diaria gratuita. Casos de uso y beneficios Imagina que estás en un grupo de amigos y alguien llega tarde. Abres Meme Picture en el móvil, subes una selfie, eliges Woman Yelling at Cat, escribes «Dijiste que estarías listo a las 8», generas y en medio minuto tienes una imagen lista para usar. Si eres community manager, puedes preparar una serie de memes con tu cara o la de un compañero para una campaña; el estilo cartoon unifica la identidad visual. Si tienes una mascota, puedes subir una foto de tu gato y convertirlo en Grumpy Cat con el estilo dibujo a mano. Los docentes pueden ilustrar una idea con This Is Fine para hablar de gestión del estrés. Los packs permanentes son útiles para campañas puntuales sin suscripción. La posibilidad de descargar sin marca de agua en Pro aporta un acabado profesional para publicaciones. Precios y tipos de planes Meme Picture sigue un modelo freemium. La versión gratuita no requiere registro e incluye tres generaciones diarias, dos candidatos por solicitud y marca de agua. El plan Pro mensual cuesta 9,99 US$ al mes e incluye hasta treinta generaciones diarias, cuatro candidatos por solicitud, ausencia de marca de agua, memes GIF, exportación HD e historial en la nube. El plan Pro anual cuesta 79,99 US$ al año y equivale a un ahorro del 33 %. También existen packs permanentes de diez generaciones por 2,99 US$ y de treinta generaciones por 6,99 US$, que no caducan y se utilizan después de agotar la cuota diaria. Esta combinación permite tanto un uso ocasional sin coste como un uso intensivo sin suscripción. Por qué destaca frente a otras opciones A diferencia de Imgflip y Canva, que están más orientadas a añadir texto sobre imágenes generales, Meme Picture está construida para el flujo específico de poner tu cara en un meme. Esto se nota en los pequeños detalles: las plantillas ya están preparadas para el encaje facial, los estilos visuales imitan la estética de los memes y el resultado final sale con una composición coherente. No hay que buscar la plantilla en un banco de imágenes, recortar el rostro a mano ni ajustar capas. Todo el trabajo tedioso queda automatizado, de modo que el usuario se centra únicamente en el mensaje y el tono. Esta orientación convierte a Meme Picture en una herramienta práctica para cualquier persona que quiera expresar una reacción propia sin pasar por un editor complejo. Privacidad y confianza La privacidad es hoy un factor decisivo para muchas personas. Meme Picture afirma que elimina la foto original inmediatamente después de la generación. Los usuarios no registrados no conservan ningún archivo en el servicio y los registrados solo guardan las imágenes finales. La plataforma asegura que no entrena modelos con las fotos de los usuarios ni vende esos datos. Este enfoque es especialmente tranquilizador para quienes suben fotografías de menores o de mascotas. Frente a otras herramientas que almacenan las imágenes durante periodos largos, esta política de borrado rápido representa una ventaja competitiva relevante. Para los usuarios españoles, preocupados por el RGPD, la claridad del mensaje sobre privacidad transmite seguridad y ayuda a decidirse a probar la herramienta. Usabilidad móvil y de escritorio La página está optimizada para funcionar tanto en ordenador como en teléfono móvil. En un ordenador se puede arrastrar y soltar una fotografía directamente sobre el área de carga. En el móvil, el flujo táctil es igual de simple: tocar para subir, elegir plantilla con un toque y generar. No es necesario instalar ninguna aplicación. Esta característica responde a la realidad de los grupos de chat, donde la mayoría de los memes se crean y comparten desde el teléfono. La carga de la página es suficientemente ligera y la generación no depende de la potencia del dispositivo, ya que el procesamiento se realiza en el servidor. Por eso un móvil de gama media puede producir el mismo resultado que un equipo de escritorio. Optimización de resultados Para obtener los mejores memes, la página ofrece algunos consejos y trucos básicos: usar una selfie clara y bien iluminada, evitar fotos con fondos muy recargados y elegir una plantilla que encaje con la expresión de la cara. También permite probar una foto de muestra de retrato o de mascota, lo que resulta útil para entender qué tipo de imagen funciona mejor. Las instrucciones adicionales opcionales permiten pedir a la IA un estilo concreto o un encuadre más ajustado. Aunque el proceso es automatizado, estos pequeños ajustes ayudan a optimizar el acabado final sin complicar la experiencia. La combinación de simplicidad y control básico es uno de los puntos fuertes del sitio. Comunidad y contenido Meme Picture no es solo un generador; también funciona como un pequeño catálogo de cultura de memes. Cada plantilla clásica cuenta con su propia página, donde se explica la historia del formato, se sugieren pies de foto y se responden preguntas frecuentes. Esto convierte la herramienta en un recurso útil para quienes quieren entender mejor los memes que usan a diario. Para los usuarios españoles que han crecido con estos formatos en foros y redes, reconocer las plantillas genera una conexión inmediata. El contenido está redactado de forma concisa, sin tecnicismos, y orientado a la acción: elegir plantilla, generar y compartir. Conclusión MP Meme Picture resuelve un problema concreto de manera muy directa: permite poner tu cara en un meme clásico sin registro, sin software de edición y sin esperas largas. Su modelo freemium, su política de privacidad y su catálogo de plantillas reconocibles lo convierten en una opción atractiva para el público general y para profesionales del contenido. La experiencia de usuario es intuitiva, el procesamiento automatizado ahorra tiempo y los resultados están optimizados para compartir al instante. Para cualquier persona en España que quiera crear un meme personal con su propia cara o la de su mascota, Meme Picture ofrece una solución lista para usar, práctica y más eficiente que los flujos tradicionales.
Generador de Intercambio de Rostros AI
Freemium
Merge Two Photos - Combina dos fotos gratis: lado a lado, apiladas, superpuestas o IA. | Top 4 AI Tool loading
Merge Two Photos se presenta como una solución lista para usar (ready to use) dentro del ecosistema de herramientas fotográficas en línea. Nacida para quienes necesitan unir dos imágenes sin fricciones, la plataforma apuesta por una experiencia directa, sin instalaciones y sin costes ocultos. Su propuesta gira en torno a la idea de que combinar dos fotografías no debería requerir programas pesados ni conocimientos avanzados de edición. En este sentido, la herramienta hace que todo el flujo de trabajo sea mucho más eficiente (more efficient), eliminando pasos innecesarios y centrándose en el resultado final. El sitio se posiciona claramente como un recurso gratuito y accesible para fusionar dos fotos desde el navegador. No es un editor de imágenes completo, ni lo pretende. Su especialización es precisamente su mayor fortaleza: ofrecer cuatro modos de fusión muy claros (lado a lado, arriba/abajo, superposición e IA) para que cualquier persona, independientemente de su nivel técnico, pueda crear una composición en pocos minutos. La promesa de privacidad es otro pilar fundamental: los modos locales procesan las imágenes en el dispositivo del usuario, sin subirlas a servidores. Solo la fusión con IA requiere una carga temporal, y la web lo comunica con total transparencia. Desde el punto de vista del posicionamiento, Merge Two Photos compite en un mercado saturado de editores fotográficos, pero se diferencia por su simplicidad radical. Mientras que plataformas como Canva o Photoshop ofrecen cientos de funciones que pueden abrumar, esta herramienta reduce la tarea a lo esencial (the essential): seleccionar un modo, subir dos imágenes y descargar el resultado. Ese enfoque minimalista resulta especialmente atractivo para quienes buscan una utilidad concreta sin tener que crear una cuenta, aprender una interfaz compleja o pagar una suscripción. El público objetivo es amplio y diverso. Creators de contenido para redes sociales encuentran en los modos lado a lado y apilado una forma rápida de crear collages visuales. Vendedores de marketplaces como Etsy o Wallapop pueden mostrar dos ángulos de un producto en una sola imagen, mejorando la presentación de sus listados. Diseñadores y community managers aprovechan la superposición para insertar logotipos, sellos o referencias visuales sobre una imagen de fondo. Profesores y estudiantes utilizan la herramienta para elaborar comparativas didácticas, antes y después, o presentaciones escolares. Viajeros y aficionados a la fotografía disfrutan de la posibilidad de combinar dos momentos de un mismo lugar en una única publicación. Pequeñas empresas y emprendedores también se benefician al no necesitar software de pago para crear piezas visuales sencillas. En cuanto a las funcionalidades principales, el modo lado a lado coloca dos fotos en horizontal dentro de una imagen amplia, igualando las alturas sin recortes por defecto, lo que resulta perfecto para comparaciones, retratos, dípticos de viajes y fotografías de producto. El modo arriba/abajo apila las imágenes verticalmente en una composición alta, ideal para tiras de antes y después y collages verticales. El modo superposición permite colocar una imagen pequeña en primer plano sobre una base más grande, con una posición predeterminada en la esquina inferior izquierda; es útil para stickers, logotipos o inserciones de imagen sobre imagen. El modo IA fusiona dos fotos mediante un prompt descriptivo, generando una escena nueva y sin cortes bruscos; es opcional, gratuito y puede subir las imágenes para su procesamiento. La experiencia de usuario es deliberadamente sencilla. Nada más entrar, el usuario ve cuatro tarjetas visuales que explican cada modo de fusión. Después, dos zonas de carga permiten arrastrar o seleccionar las imágenes en formatos JPG, PNG, WEBP o HEIC, con un tamaño máximo de 10 MB por archivo. El botón de intercambio resuelve cualquier confusión en el orden de las fotos. En los modos locales, basta con pulsar Merge para obtener una vista previa y descargar el PNG. En el modo IA, se escribe una breve descripción y se pulsa Generate. La curva de aprendizaje es prácticamente inexistente. El contenido complementario es otro punto fuerte. La web incluye una sección de guías con tutoriales paso a paso, como combinar fotos en Android y iPhone, fusionar imágenes en un solo marco, usar la superposición o el reemplazo de fondo con IA, y hasta alternativas a Canva sin registro. Estas guías ofrecen consejos y trucos (tips and tricks) para lograr collages más limpios: igualar iluminación y resolución, mantener los sujetos principales lejos de la línea de corte, usar una esquina tranquila en la superposición o redactar prompts de IA más precisos. Este enfoque educativo refuerza la autoridad del sitio y ayuda a los usuarios a obtener mejores resultados. En el plano técnico, Merge Two Photos aprovecha el procesamiento en el navegador para los modos locales. Esto implica que las imágenes no se suben a ningún servidor durante la edición, lo que supone una ventaja de privacidad y velocidad. La ausencia de marca de agua en las descargas PNG exitosas garantiza un acabado profesional. Para el modo IA, las imágenes se suben temporalmente; los archivos de invitados se conservan aproximadamente 24 horas y los de usuarios registrados alrededor de 30 días, según la política de privacidad. La web es completamente responsive, por lo que funciona tanto en móviles como en escritorio sin necesidad de aplicaciones adicionales. El modelo de precios se basa en la gratuidad. Las fusiones locales son gratuitas y sin marca de agua. La fusión con IA también es gratuita, con límites de uso justo diarios, concretamente cinco fusiones gratuitas al día. No se mencionan planes de pago, suscripciones ni compras dentro de la aplicación. Esta ausencia de barreras económicas convierte a la herramienta en una opción atractiva para usuarios ocasionales y para quienes solo necesitan resolver una tarea puntual sin comprometerse con una cuenta o una tarjeta de crédito. Los casos de uso son innumerables. Un vendedor puede preparar una ficha de producto con dos vistas; un community manager puede crear una publicación comparativa; un docente puede elaborar una ficha de evolución; un viajero puede compartir una panorámica emocional; un diseñador puede presentar un mockup con logotipo. En todos estos escenarios, la herramienta aporta velocidad, limpieza y control sobre el resultado final. Más allá de sus funciones, Merge Two Photos transmite cercanía y honestidad. La comunicación es clara: no promete milagros, explica cuándo conviene cada modo y detalla las políticas de retención. Esa transparencia genera confianza, algo muy valioso cuando se manejan imágenes personales o de clientes. Además, el hecho de que no pida registro para las funciones básicas elimina una fricción habitual en los servicios en línea. En definitiva, Merge Two Photos es una herramienta práctica, ligera y directa que resuelve una necesidad concreta con una ejecución impecable. Su combinación de modos locales respetuosos con la privacidad, una opción de IA creativa, contenido educativo de calidad y un modelo gratuito la posicionan como una referencia en el nicho de la fusión de imágenes. Para el público español, acostumbrado a buscar soluciones rápidas y efectivas, representa una opción cómoda e intuitiva que merece un lugar en la caja de herramientas digital de cualquier persona que trabaje con fotografías.
Editor de Fotos e Imágenes
Free
Picture Enhancer - Mejora, reescala y restaura fotos online con IA sin instalación | Top 4 AI Tool loading
Cuando una fotografía importante pierde nitidez, no solo se pierde detalle: se pierde la emoción, la memoria y, en muchos casos, la capacidad de comunicar. Picture Enhancer nace para devolver esa claridad con una herramienta lista para usar que no exige conocimientos de edición ni instalaciones pesadas. Es un potenciador de imágenes en línea, independiente y centrado en tres tareas esenciales: desenfocar, ampliar y restaurar. A lo largo de esta guía, descubrirás cómo esta plataforma se convierte en una aliada para creadores, vendedores, genealogistas y cualquier persona que quiera mejorar sus imágenes de forma rápida, segura y emocionalmente significativa. Imagina que tienes delante una fotografía que cuenta una historia: la boda de tus abuelos, la primera sonrisa de tu hijo o una captura de pantalla con la interfaz de tu nuevo proyecto. Sin embargo, el desenfoque, la baja resolución o las marcas del tiempo le roban nitidez. Picture Enhancer llega como una solución lista para usar, diseñada para devolver a cada imagen la claridad que merece sin instalaciones, sin complicaciones y sin perder tiempo. Esta plataforma independiente de mejora de imágenes con inteligencia artificial se posiciona como un espacio en línea donde el desenfoque, la falta de detalle y los daños de fotos antiguas se convierten en oportunidades para emocionar, convencer y comunicar mejor. El posicionamiento de la web es claro: no pretende sustituir a los grandes editores de escritorio, sino ofrecer un flujo más eficiente para quienes necesitan resultados inmediatos. Su promesa principal es simple: sube una imagen, elige un modo y una intensidad, compara el antes y el después, y descarga sin marca de agua. Es un enfoque directo que elimina fricciones y transforma una tarea que antes requería programas complejos en una acción de tres pasos al alcance de cualquier persona. El público objetivo es amplio y diverso. Por un lado, están los creadores de contenido y community managers que publican a diario en redes sociales y necesitan capturas de pantalla legibles o imágenes atractivas sin depender de un diseñador. Por otro, los responsables de e-commerce que manejan catálogos con fotografías de producto pequeñas o comprimidas y quieren que sus listados destaquen. También encontramos a los genealogistas y aficionados a la historia familiar, que buscan rescatar fotografías antiguas dañadas por el paso del tiempo. Los redactores técnicos y creadores de documentación aprecian la posibilidad de mejorar capturas de interfaz para que los tutoriales sean claros y profesionales. Por último, los fotógrafos aficionados y estudiantes encuentran aquí un primer recurso accesible para corregir desenfoques leves y preparar sus imágenes para portafolios o impresiones. Las capacidades principales giran en torno a tres modos básicos. El primero es el deblur con inteligencia artificial, que reconstruye bordes y texturas afectados por el movimiento de cámara, el enfoque suave o el desenfoque leve. Puedes elegir entre intensidad Estándar, Fuerte o Súper según la gravedad del problema, de modo que los rostros y los textos vuelvan a leerse con claridad. El segundo modo es el upscale inteligente de 2× o 4×, que añade detalle para portadas sociales, fotografías de producto o vistas previas de impresión cuando partes de un archivo pequeño. El tercero es la restauración de fotos antiguas y daños, que reduce arañazos, decoloración y artefactos de compresión; las intensidades Fuerte y Súper manejan daños más severos en impresiones familiares escaneadas. Una de las características más valiosas de Picture Enhancer es su espacio de trabajo en línea. No necesitas descargar ningún programa: todo sucede en el navegador. El diseño está pensado para ser simplificado y profesional al mismo tiempo. A la izquierda se muestra la comparación antes y después con un deslizador interactivo, y a la derecha se encuentran los controles de subida y ajuste. Esta disposición recuerda a las herramientas profesionales, pero sin la curva de aprendizaje que suele acompañarlas. Además, el sistema admite archivos JPG, PNG y WebP, y procesa una imagen a la vez para usuarios invitados, mientras que los suscriptores y compradores de paquetes pueden subir hasta diez imágenes por lote. La experiencia de usuario está cuidada hasta el último detalle. Desde la primera visita, la web ofrece tres pruebas gratuitas de por vida por dirección IP, sin necesidad de registro. Esto es un gesto de honestidad poco común: puedes comprobar la calidad real de la mejora antes de decidir si quieres invertir. Una vez que subes una imagen y eliges el modo, el procesamiento ocurre en segundos y el resultado se muestra en una comparación clara. Si el resultado es correcto, descargas el archivo sin marca de agua y en su formato original. Si el proceso falla, no se descuentan créditos, lo que refuerza la confianza del usuario. Para quienes deciden registrarse, la plataforma añade beneficios prácticos. Los usuarios nuevos reciben 10 créditos de bienvenida. El coste por intensidad es transparente: Estándar cuesta 2 créditos, Fuerte cuesta 4 y Súper cuesta 6, y solo se cobran cuando el resultado se genera con éxito. Los suscriptores pueden acceder a los niveles Súper y al procesamiento por lotes, mientras que los compradores de paquetes permanentes obtienen créditos que no caducan. Esta flexibilidad permite elegir entre un plan mensual para uso continuo o un paquete puntual para proyectos concretos. Las características de contenido también merecen atención. La página no se limita a vender una herramienta; ofrece una guía práctica mediante una sección de preguntas frecuentes bien organizada, que aborda dudas sobre pruebas gratuitas, facturación, modos compatibles, marcas de agua, suscripciones, paquetes de créditos, privacidad y descargas. Además, incluye referencias a fuentes externas como Wikipedia para contextualizar las técnicas de superresolución, escalado y desenfoque. Esto aporta credibilidad y demuestra que el equipo editorial conoce los fundamentos técnicos detrás de su propuesta. La presencia de una sección «Por qué Picture Enhancer» con testimonios de usuarios reales contribuye a generar confianza y cercanía emocional. En cuanto a las características técnicas, la plataforma funciona íntegramente en el navegador y no requiere instalación. El procesamiento es privado: las subidas se utilizan únicamente para completar la solicitud de mejora, no se comparten ni se emplean para otros fines. La entrega de resultados es rápida y libre de marcas de agua. El sistema de créditos está integrado en la interfaz, con un panel «Mis créditos» para consultar el saldo y las transacciones, y un panel «Mis activos» para revisar los resultados recientes. Esta combinación de privacidad, rapidez y control convierte a Picture Enhancer en una opción muy completa para un servicio web. La propuesta de valor se completa con una estructura de precios clara. Los invitados pueden probar tres veces sin pagar. Después, la opción gratuita se transforma en un modelo freemium con créditos de bienvenida y precios por intensidad. Las suscripciones mensuales ofrecen créditos recurrentes: 200 créditos por 8 USD, 1.000 por 25 USD y 2.000 por 45 USD. Los paquetes permanentes no caducan y son ideales para recargas flexibles. Ambos sistemas desbloquean los niveles Súper y el procesamiento por lotes. No hay costes ocultos y los créditos solo se descuentan cuando el procesamiento termina con éxito, lo que refuerza la sensación de justicia y transparencia. Desde una perspectiva emocional, Picture Enhancer conecta con las historias personales. Restaurar una fotografía antigua no es solo una cuestión técnica: es devolver a una familia la posibilidad de volver a ver un rostro querido con nitidez. Mejorar una captura de pantalla no es solo una tarea laboral: es la diferencia entre un tutorial confuso y una guía que realmente ayuda. Ampliar la foto de un producto no es solo estética: es aumentar la probabilidad de que un cliente se enamore de lo que ve. La herramienta entiende estas motivaciones y las traduce en una experiencia que cuida tanto el resultado como el proceso. Los trucos y consejos para sacar el máximo partido son sencillos. Si necesitas un resultado rápido para una captura con texto borroso, empieza con deblur Estándar y revisa la comparación. Si la imagen es muy pequeña y quieres usarla en una portada, opta por upscale 2× o 4× con intensidad adecuada. Para fotografías antiguas con arañazos y manchas, elige restaurar Fuerte o Súper y compara con calma. Aprovecha las tres pruebas gratuitas para conocer los modos y decide después si te conviene una suscripción mensual o un paquete permanente. Inicia sesión antes de procesar lotes grandes para guardar el historial y gestionar mejor los créditos. En resumen, Picture Enhancer es una plataforma de mejora de imágenes en línea que combina accesibilidad, transparencia y calidad. Su enfoque simplificado elimina las barreras de entrada y permite que cualquier persona, desde un community manager hasta un genealogista apasionado, obtenga resultados profesionales sin instalar software. La combinación de deblur, upscale y restauración con intensidades configurables cubre las necesidades más comunes del tratamiento de imagen cotidiano. La política de privacidad respeta al usuario y el sistema de créditos solo cobra por resultados exitosos. Todo ello convierte a esta herramienta en una opción más eficiente para quienes valoran su tiempo y quieren que sus imágenes vuelvan a brillar con claridad. Picture Enhancer no solo mejora fotografías: mejora la forma en que compartimos recuerdos, ideas y productos. Es una puerta abierta a la creatividad sin fricciones, un puente entre la imagen imperfecta y la comunicación efectiva. Si buscas una manera práctica, segura y emocionalmente gratificante de devolver nitidez a tus capturas, esta plataforma merece un lugar en tu flujo de trabajo diario.
Editor de Fotos e Imágenes
Freemium
Yevideo AI - El estudio de IA para vídeo e imagen perfecto. | Top 4 AI Tool loading
Yevideo AI se presenta como la plataforma integral de creación de vídeo e imagen mediante inteligencia artificial más completa y **Simplified** del mercado. Nuestro objetivo es democratizar la creación de contenido audiovisual, poniendo al alcance de todos, desde profesionales hasta aficionados, las herramientas más potentes y vanguardistas. Olvídate de los complicados softwares de edición y los largos procesos de aprendizaje. Con Yevideo, tu única tarea es describir tu idea y dejar que la magia de la IA la haga realidad. Nuestra plataforma no es un simple generador; es un **Integrated** ecosistema que agrupa una impresionante colección de los mejores modelos de IA del mundo. Desde el innovador Gemini Omni Video de Google, que utiliza el conocimiento del mundo y el razonamiento físico para generar vídeos de alta calidad, hasta el potente Kling 3.0, especializado en la imitación de movimientos, pasando por el versátil Seedance 2.0 para un control cinemático impecable. Para la generación de imágenes, ofrecemos modelos como Nano Banana Pro, una **Practical** herramienta de productividad de grado de diseño que sobresale en la representación de texto multilingüe, y FLUX, conocido por su asequibilidad y consistencia multi-imagen. La clave de Yevideo es que no solo te exponemos los modelos, sino que te ayudamos a elegir el más adecuado para cada tarea, guiándote hacia resultados que realmente te satisfagan. El flujo de trabajo en Yevideo es **Intuitive**. Todo comienza con una idea. Puedes partir de un texto para generar una imagen, usar esa imagen como referencia para crear un vídeo, o incluso editar un vídeo existente mediante instrucciones de texto. Nuestra plataforma soporta una amplia gama de flujos de trabajo completos: de texto a imagen, de imagen a imagen, de texto a vídeo, de imagen a vídeo, de vídeo a vídeo y edición de vídeo por IA. Una ruta común y muy **Efficient** es comenzar con la generación de texto a imagen para visualizar un concepto, luego usar la función de imagen a imagen para iterar variaciones o refinar el resultado, y finalmente convertir esa imagen estática en movimiento con la herramienta de imagen a vídeo. Este enfoque paso a paso te permite controlar cada etapa del proceso creativo, ahorrando créditos y asegurando que el resultado final sea exactamente lo que imaginabas. Para el público español, Yevideo AI representa un salto cualitativo en la creación de contenido. Imagina a un creador de contenido en Madrid que necesita un vídeo promocional para su nuevo producto. Con Yevideo, puede describir el producto, elegir un estilo visual, y en cuestión de segundos, obtener un vídeo de alta calidad listo para publicar en redes sociales. O piensa en un pequeño negocio en Barcelona que quiere crear imágenes profesionales para su catálogo online sin tener que contratar a un fotógrafo. Gracias a modelos como Nano Banana Pro, pueden generar imágenes de producto con texto perfectamente integrado y un acabado impecable. La plataforma también es ideal para agencias de publicidad que necesitan prototipos rápidos de campañas, para educadores que quieren crear material didáctico visual atractivo, o para artistas digitales que buscan explorar nuevas fronteras creativas. Nuestra plataforma también está diseñada pensando en la experiencia del usuario. La interfaz es limpia, moderna y altamente responsive. Hemos eliminado la fricción técnica para que puedas centrarte en lo que realmente importa: tu creatividad. Con funciones como el control de fotograma inicial y final en modelos como Veo 3.1 Fast, puedes mantener la coherencia de estilo y contenido en tus vídeos. La función de control de cámara en Veo 3.1 Quality te permite realizar zooms, paneos y giros de cámara con una fluidez asombrosa. Y con los modelos de edición de vídeo como HappyHorse Video Edit, puedes modificar escenas existentes: cambiar la iluminación, reemplazar elementos o transformar un día soleado en una noche de invierno, todo con simples instrucciones de texto. En el aspecto técnico, Yevideo se apoya en una infraestructura robusta y escalable. Cada generación requiere un consumo de créditos que se calcula en función del modelo seleccionado y la configuración (resolución, duración, número de salidas). Antes de generar, siempre verás un coste estimado, dándote control total sobre tu presupuesto. Para nuevos usuarios, ofrecemos un bono de bienvenida para que puedas probar las funciones principales. Además, puedes obtener créditos gratuitos mediante el check-in diario y recompensas por compartir sugerencias que sean implementadas. Próximamente, añadiremos un programa de referidos para que puedas ganar créditos cuando tus amigos se registren. Yevideo AI es más que una herramienta; es un socio creativo. Te ofrecemos una plataforma **Ready to use**, donde la complejidad técnica se oculta tras una interfaz sencilla y potente. Ya seas un profesional del marketing, un diseñador gráfico, un educador, un emprendedor o simplemente un entusiasta de la IA, Yevideo te proporciona las herramientas que necesitas para dar vida a tus ideas. Con una comunidad activa y un equipo comprometido con la innovación, estamos construyendo el futuro de la creación de contenido. Únete a nosotros y descubre lo que la IA puede hacer por ti.
Generador de Vídeo AI
Freemium

Frequently Asked Questions

What is MaoMaoYu Top4 AI Tools Directory?

Top 4 AI — '4' means 'For', MaoMaoYu Top For AI Tools Directory - top4ai.com is building an ai tools directory that helps you get your favorite ai tools, free ai tools list. It can get best ai writing tools, best free ai tools for writing articles, content at scale ai detector, best ai email marketing tools, ai paraphrasing tools, best ai seo tools, ai study tools, 'pearson' and 'ai' and 'study tools', ai generator tools, ai hashtags generator tools, best ai tools for research, ai art tools, ai music tools, ai video editing tools, ai pair coding tools, ai photo tools, ai tools for detecting photoshopped imagers, best ai tools for start up companies who are researching their market and more here.

How to found your ai tools in MaoMaoYu Top4 AI tools directory?

1. Open top4ai.com.

2. Explore the ai tools in the MaoMaoYu Top4 AI tools directory.

3. Click the ai tools that you need to get the detail and visit it.

What are the main features of MaoMaoYu Top4 AI Tools Directory?

1. Explore a simple definition of AI tools and discover how to fast find the perfect one for your needs. Streamline your workflow with the right AI solution.

2. Intelligent Search Engine: Thinking of what you think, saving you time, saving you trouble

Is it free to submit ai tools to MaoMaoYu Top4 AI Tools Directory?

Yes, it's free currently.

What's the categories list of AI Tools that MaoMaoYu Top4 AI Tools Directory support?

We will support all kinds of AI Tools later. Please wait for a few days.

What's the frequency for the up of AI tools in MaoMaoYu Top4 AI Directory?

The list of AI tools will be updated daily.

Is it support QuillBot, GPT-4o or Sora AI here?

You can get the QuillBot, GPT-4o or Sora AI tool here. Here is the introduction of GPT-4o and Sora video, and you can visit the website of the tools.

Troubleshooting

If the content aren't appearing, try a different browser, clear your cache. If issues persist, contact us at support@top4ai.com | support@maomaoyu.coffee.

What are the usage rights of the AI tools?

MaoMaoYu Top4 AI Tools Directory is just the AI Directory for AI tools. The usage rights of the AI tools are based on the AI tools' website.