2026-03-07 07:40:08
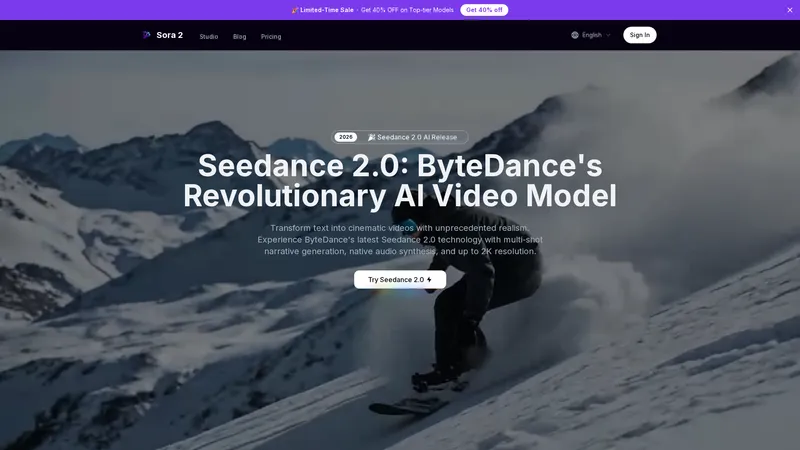
Seedance 2.0 - Transform text into cinematic videos with unprecedented realism.
Categories
AIアニメーションビデオAIビデオエディターAIビデオジェネレーター
Users of this tool
Independent Filmmakers & DirectorsMarketing & Advertising ProfessionalsSocial Media Content Creators & InfluencersGame Developers & AnimatorsCorporate Training & E-learning Developers
PricingType
Subscription

Links

  1. Login: https://seedance-2.top/studio
  2. Pricing: https://seedance-2.top/#pricing

Seedance 2.0 AI Video Generator, powered by ByteDance's revolutionary Seedance 2.0 model, is a cutting-edge platform that transforms simple text prompts or reference images into high-definition, cinematic videos. This platform is designed to be ready to use, offering an integrated and streamlined workflow that combines video and native audio generation into one efficient process. It empowers creators to produce professional-grade content with features like multi-shot narrative generation, support for up to 2K resolution, and synchronized audio synthesis. Whether for commercial advertising, cinematic storytelling, or social media content, Seedance 2.0 provides practical tools to optimize production speed and creative output, making advanced video creation accessible and simple.

Top Features

  1. Multi-Shot Narrative Generation with 'Director in the Machine'
  2. Native Audio Synthesis with Lip-Sync Support
  3. Up to 2K Resolution Video Output
  4. Multimodal Input (Text and Image to Video)
  5. Video Reframing Tool for Aspect Ratio Changes
  6. Integrated Workflow Reducing Post-Production Needs
  7. Commercial License for Professional Use

Simple Definition of Usecases

  1. A film director uses the Multi-Shot Narrative feature with a detailed script prompt to generate a complete storyboard sequence for a short film. The platform maintains character consistency across different shots and angles, while the Native Audio Support generates ambient sound and placeholder dialogue, saving weeks of pre-visualization work.
  2. A marketing manager for a luxury brand uses the Image to Video mode with a product photo. They specify 'cinematic low-angle tracking shot' in the prompt. Seedance 2.0 generates a 1080p video with professional lighting and camera movement, and the integrated audio tool adds a sophisticated voiceover, creating a high-end ad prototype in minutes instead of days.
  3. A YouTuber creating anime reviews uses the platform to generate original multi-shot anime sequences based on their written descriptions. The tool ensures perfect pacing between establishing shots and close-ups, weaving in dialogue and sound effects to create engaging, cohesive narrative clips for their channel intro.
  4. An indie game developer needs a cinematic trailer. They input a description of a key game scene. Seedance 2.0 generates an immersive 2K resolution cutscene with precise audio-visual locking, where character footsteps and environmental sounds are perfectly synchronized with the on-screen action, providing a high-quality asset for their Kickstarter campaign.
  5. A corporate trainer uses the Text to Video feature to quickly convert a training module on cybersecurity into an engaging video. The platform generates clear, concise visuals with a professional tone and adds relevant background music, creating an effective e-learning asset without needing video editing software or voice actors.

User Reviews

Anya Petrova

Documentary Filmmaker

★★★★★

"As a documentary filmmaker, pre-visualization is crucial. Seedance 2.0 has been a game-changer. The 'Director in the Machine' feature is not marketing fluff; it genuinely understands scene composition. I fed it a complex prompt about a historical reenactment with multiple character interactions. The generated sequence had logical shot progression—wide establishing shot, medium two-shot for dialogue, and close-ups for emotional emphasis. The native audio, while synthetic, provided a surprisingly accurate bed of ambient crowd noise and room tone that matched the visual period setting. This allowed me to pitch the scene's mood to my producers with a tangible asset, not just storyboards. The streamlined workflow meant I didn't have to juggle separate audio editing software. For rapid prototyping and communicating directorial intent, it's an indispensable tool that has optimized my pre-production phase significantly."

Frequently Asked Questions

Q:

What is Seedance 2.0 and how does it differ from other AI video models?

A:

Seedance 2.0 is ByteDance's latest AI model for generating videos from text or images. Its key differentiators are 'Director in the Machine' technology for coherent multi-shot narratives, native audio synthesis (generating sound and video together), and support for up to 2K resolution. Unlike models that simply animate a single scene, it plans shots and maintains consistency like a human director.

Q:

What does the 'native audio support' feature do?

A:

Native audio support means the Seedance 2.0 model generates synchronized sound—including dialogue, ambient noise, sound effects, and music—directly within the same process as the video. This ensures perfect timing between audio and visual actions and eliminates the need to add and align sound in post-production software.

Q:

What to expect in terms of video quality and resolution?

A:

You can expect professional-grade video quality. Seedance 2.0 supports generation in resolutions up to 2K (1080p is standard), offering exceptional visual clarity suitable for social media, presentations, and broadcast prototypes. The model is designed for cinematic output with realistic details and consistent visual style.

Q:

How to use a reference image with Seedance 2.0?

A:

In the 'Image to Video' mode, simply upload a reference image (JPG, PNG). The AI uses this image to guide the style, composition, and elements of the first frame of your generated video, ensuring visual consistency with your initial concept or brand assets.

Q:

How to fast generate a video for social media?

A:

For fast social media clips: 1) Select the 'Text to Video' mode. 2) Choose the target aspect ratio (e.g., 9:16 for Reels/TikTok). 3) Write a concise, descriptive prompt focusing on the key action and mood. 4) Select a shorter video length (4-6 seconds). 5) Click 'Generate'. The integrated audio means your video will be complete with sound, ready to download and post immediately.

Q:

Can I use the videos for commercial purposes?

A:

Yes, videos generated on the platform come with a commercial license under the Pro and Pro Max subscription plans, allowing you to use them in client work, advertisements, and monetized content. Please review the specific terms of service for detailed licensing information.

Q:

What is the video reframing tool?

A:

The video reframing tool allows you to upload an existing video (up to 30 seconds) and change its aspect ratio (e.g., from 16:9 to 9:16) without cropping important content. The AI intelligently adjusts the composition to fit the new frame, which is perfect for repurposing content across different social platforms.

Q:

Do credits expire?

A:

No, according to the pricing information, credits do not expire. Unused credits roll over month-to-month as long as your subscription remains active, providing flexibility in usage.

Related AI Tools
VidRush AI - AI動画・画像・音楽を一つのスタジオで創り出すオールインワン生成AI | Top 4 AI Tool loading
VidRush AIは、テキストや画像、既存の動画、そして音楽のアイデアを、ワンストップでプロ品質のクリエイティブ資産に変換できるオールインワンAIクリエイティブスタジオです。Google Veo 3.1、Seedance 2.5 / 2.0、Kling 3.0、Wan 2.6、Nano Banana Pro、Seedream 5.0、GPT Image 2、Suno 5.5といった、現在もっとも注目される最先端AIモデルを1つのワークスペースに統合しているのが最大の特徴です。動画生成、画像生成、音楽生成を個別のツールやサブスクリプションで管理する必要がなく、ログインし直したり、ファイルを移動したりする手間を大幅に削減できます。 VidRush AIの本質は、単なるAIツールの集合体ではなく、クリエイターの制作ワークフローを最初から最後までシームレスにつなぐ統合環境にあります。たとえば、YouTube用の動画を作りたい場合、テキストからメイン映像を生成し、Nano Banana Proでサムネイル画像を作成し、Suno 5.5でBGMを生成するという一連の作業を、すべてVidRush AI上で完結できます。従来であれば複数の有料ツールを契約し、生成結果を手動で組み合わせる必要がありましたが、VidRush AIを導入すれば、より効率的にアイデアを形にできます。 まず「テキストからビデオ生成」では、プロンプトやナラティブスクリプトを入力するだけで、映画的なカメラワーク、自然な物理挙動、シーンに合わせた音声まで同期された動画を制作できます。対応モデルはGoogle Veo 3.1、Seedance 2.0、Kling 3.0などで、それぞれのモデル特性に応じて、リアルな人物表現、アニメーション、シネマティックな映像スタイルを使い分けることが可能です。また「画像からビデオ生成」では、静止画のポートレートや商品写真、アート作品をアップロードするだけで、自然なライティングとキャラクターの一貫性を保ったまま、高精細な動画クリップに変換できます。モデルにはSeedance 2.5、Veo 3.1、Wan 2.6が採用されており、特に静止画のキャラクターが動いても顔の特徴やデザインが崩れにくい点は、クリエイターにとって大きな利点です。 さらに「ビデオからビデオ生成」は、既存の映像素材を別のアートスタイルへ変換したり、特定の振り付けを別キャラクターで再現したり、映像を延長したりする機能です。マルチリファレンス指定により、複数の画像や映像を参照させながら、統一感のある新しい映像を作り出せます。動画編集者が素材を活用する際に求められる「変換精度」「キャラクターの同一性」「モーションの再現性」といった細かなニーズに、Seedance 2.0、Kling O1、Wan 2.6 R2Vが応えます。 画像生成分野では「テキストから画像生成」が利用できます。フォトリアルなポートレート、商業用の商品カット、コンセプトアート、イラストなどを、自然言語のプロンプトだけで制作できます。対応モデルにはNano Banana Pro、Seedream 5.0、GPT Image 2があり、肌の質感やライティング、複雑なタイポグラフィを含むデザイン、細部まで計算された構図などを高い次元で再現します。また「画像から画像生成」では、既存の画像をアップロードしてアニメ調、3DCGI風、ハイレゾ版などへリミックスしたり、拡張したりできるため、SNS投稿用のビジュアルを量産する際にも重宝します。 音楽制作の分野では「AIミュージックジェネレーター」が用意されています。歌詞やテキストプロンプトを入れるだけで、自然な人間のボーカル、豊かな楽器編成、フルダイナミックレンジを備えた楽曲を生成できます。Suno 5.5、Suno 5.0、Suno 4.5に対応しており、ボーカル入りの歌ものからインストゥルメンタル曲まで幅広く制作可能です。動画のBGM、ゲーム用のサウンドトラック、企業プロモーション用のジングルなど、商用利用が明確に認められているため、権利処理を心配せずに作品へ組み込めます。 VidRush AIのインターフェースは、直感的でわかりやすいデザインを採用しています。ホーム画面には「ビデオ」「イメージ」「ミュージック」の主要カテゴリが並び、生成したいメディアタイプを選ぶだけで各ツールへ移動できます。プロンプト入力欄のほか、画像アップロード、アスペクト比設定、動画の長さ、カメラモーション、歌詞や楽器構成など、出力に影響するパラメータが明確に整理されているため、AI生成に不慣れな初心者でも迷いません。また、生成結果はワークスペース上でプレビューし、気に入らなければすぐにバリエーションを再生成できます。 実務面でも、VidRush AIは高速なGPUレンダリング基盤を備えています。画像は約5〜15秒、音楽は約1〜2分で2バリエーションが生成され、動画クリップも1〜3分ほどで完成します。動画解像度は720p、1080p Full HD、最大4Kアップスケールに対応し、16:9のワイド画面、9:16の縦型ショート動画、1:1のスクエア形式など、用途に合わせた出力が可能です。これにより、SNS広告用の縦型動画や、YouTube用の横型動画、プレゼン資料用の画像など、多様なフォーマットを迅速に用意できます。 さらに、VidRush AIは「商用利用権が100%明確」である点も重要です。有料サブスクリプションまたは購入済みクレジットパックを使って生成した成果物は、YouTube、TikTok、Instagramなどへの投稿、テレビCM、クライアント案件、ゲーム制作、ストリーミング配信など、さまざまな商用プロジェクトへ利用できます。ロイヤリティや追加ライセンス料を気にせず、収益化へつなげられるため、フリーランサーやクリエイティブエージェンシーからの信頼も高いプラットフォームです。 VidRush AIのウェブサイト全体は、モダンで視認性の高いUIを備え、ボタンやリンクも明確に配置されています。機能紹介、モデル一覧、チュートリアル的な導線、価格ページ、コミュニティショーケース、FAQ、利用規約、プライバシーポリシーなどが整理されているため、訪問者は迷わず必要な情報へアクセスできます。新規ユーザーに対しては、登録直後から動画・画像・音楽の生成をテストできる無料スタータークレジットが付与され、実際の品質を確かめてから課金プランへ移行できるという構成も親切です。 総合的に見て、VidRush AIは「動画、画像、音楽を1つのプラットフォームで作りたい」という幅広いクリエイティブニーズに応える、非常に実用的なオールインワンAIサービスです。業務で生成AIを活用したい映像制作者やWebマーケターはもちろん、これからAIクリエイティブを始める個人にもおすすめできるサービスです。複数のSOTAモデルへのアクセスを契約1つで実現できる点は、コスト面とワークフロー効率の両方で大きな価値をもたらします。今後もモデルが追加・更新されることで、クリエイターが1つのツールに使い慣れながら最新AIの恩恵を受けられる環境は、継続的な制作現場の力強い味方になるでしょう。
AI音楽ジェネレーター
Freemium
Perchance AI Image Generator - 無料・登録不要で画像生成。複数モデル切替で使い続けられるAIツール | Top 4 AI Tool loading
Perchance AI Image Generatorは、ブラウザ上で自然言語のプロンプトから画像を生成できる、無料のテキスト・トゥ・イメージツールです。このサイトは、アカウント登録やクレジットカード入力を一切求めず、ホームページ上にあるワークスペースにアクセスするだけで、すぐに画像生成を開始できることを最大の特徴としています。いわば「Ready to use」の考え方を徹底したサービスであり、初めてAI画像生成を試す人でも、モデル選択とプロンプト入力という単純なステップだけで成果物を得られます。 次に、このサービスの位置づけを明確にしておきます。Perchance AI Image Generatorは、特定のAIモデルを固定して提供するタイプのツールではありません。Z Image Turbo、FLUX.1、FLUX.2、Stable Diffusion 3/3.5、Qwen Imageなど、複数の無料公開モデルホストをまとめて操作できる、マルチモデルワークスペースです。ユーザーはドロップダウンから使用するモデルを選び、プロンプトを書き、生成ボタンを押すだけで、そのモデルが返した画像をブラウザ上でプレビューできます。GPUを直接所有するのではなく、各ホストの空き状況に応じて経路を切り替える設計のため、サイト側が売る「有料のProプラン」や「生成クレジット」は存在しません。このアーキテクチャは、一つのGPUサービスがダウンしたときに全体が停止するという単一障害点を避ける意味でも合理的です。 対象となるユーザー層も幅広いです。グラフィックデザイナーはクライアント提案用のビジュアルアイデアを短時間で作り、イラストレーターはキャラクターや背景の参考画像を手軽に扱い、SNS運用担当者は投稿用の画像案を量産できます。ブロガーや小説家は記事のアイキャッチや作品世界のイメージを具体化でき、マーケターやスタートアップの担当者は商品モックアップやプレゼン用素材を素早く作成できます。さらに、AIツールの比較・研究を行いたい開発者にとっても、複数モデルを同一UIから試せる点は大きな利点です。 中核となる機能は、まず「無料のテキスト・トゥ・イメージワークスペース」です。モデル選択、プロンプト入力、アスペクト比、ステップ、ガイダンス、シード、ネガティブプロンプト、生成、ダウンロードという一連の操作が1ページで完結します。次に「マルチモデル切り替え」です。Z Image Turboはデフォルトの高速生成モデルとして配置され、FLUX系は全体的な画質の高さ、Stable Diffusion系は柔軟な設定、Qwen Imageは異なる画風の選択肢を提供します。さらに「アスペクト比と詳細設定」に対応しており、正方形、16:9、9:16など目的に合わせた比率を選ぶことができます。モデルが対応する場合はステップ数やガイダンス強度、シード値を調整して、生成結果をより意図に近づけられます。生成が完了したら、ダウンロードボタンを押すだけで画像を保存できるのも便利です。 サイトのコンテンツも充実しています。ホームページは、Overview、Features、Tutorial、How it works、Limits & policy、Inspiration、FAQといったセクションで構成され、ユーザーは機能の概要だけでなく、実際の使い方や制限、モデルの選び方に関する情報を得られます。特筆すべきは「How to use」セクションで、ワークスペースの開き方から、モデル選択、プロンプト作成、生成、ダウンロードまでの手順をステップバイステップで解説しています。また「How it works」では、ブラウザから無料公開モデルホストへリクエストを送り、画像を受け取るという仕組みが平易に説明されています。FAQも具体的で、「無料か」「Proプランはあるか」「制限はあるか」「NSFWポリシーはどうなっているか」といった、利用者が不安に感じやすい疑問へ丁寧に答えています。 ユーザー体験の面では、登録やインストールが不要な点が非常に大きなアドバンテージです。多くの画像生成サービスがメールアドレスやクレジットカード情報を求めるのに対し、このサイトはホームページに移動して、そのまま生成を始められます。ワークスペースはモデル、プロンプト、シェイプ、ステップ、ガイダンス、シード、生成ボタン、結果表示、ダウンロードボタンという直線的なレイアウトで構成されており、初めての人でも迷いにくい設計です。モデルを切り替える理由も、結果表示部分に表示されるエラーメッセージや生成速度で自然と理解できます。いずれのモデルも混雑している場合は、「Switching models often fixes errors」といった案内が示されるため、ユーザーは次の行動をすぐに決められます。 技術的には、このサイトは画像生成の計算自体を自社サーバで行うのではなく、無料公開モデルホストが提供する生成APIを中継するような構成になっています。ユーザーがプロンプトや設定を送信すると、選択されたホスト上でモデルが推論を実行し、生成された画像がブラウザへ返されます。したがって、生成速度や品質はホストの負荷状況に依存します。特定のモデルが遅い、または失敗する場合も、別のモデルに切り替えることで作業を継続できます。この仕組みは、サイト運営側に巨額のGPUコストを強いることなく無料提供を可能にする一方で、「固定された上限を保証しない」という誠実な設計でもあります。キーワードで言えば、利用者はこの複数モデル切り替えを使いこなすことで、より効率的な(more efficient)生成フローを実現できます。 制限とポリシーについても整理しておきます。このサイトには、1日あたりの固定生成枚数という明確なカウンタはありません。ただし、無料ホスト側のキュー、コールドスタート、レート制限などが現実的な制約となります。こうした制限に直面したときの推奨策は、別モデルへ切り替えることです。また、NSFWやアンセンサード表現に関しては、サイト全体で一括解除できるようなスイッチは存在せず、各モデルホストのフィルタポリシーが適用されます。利用規約では違法コンテンツ、未成年に対する害、非同意の親密画像などを禁止しています。生成結果を商用利用する場合も、著作権やパブリシティ権、各国の法律を確認する責任はユーザーにあります。 さらに、このサイトは単なるレビューサイトでも、バージョン番号で固定された旧型ジェネレータでもありません。常に更新されるマルチモデルワークスペースであり、モデルの一覧はホスト側の更新に応じて変わります。そのため、「現在の環境はどうか」を知るには、外部の評価記事を読むよりも、実際にページを開いて試してみるほうが確実です。無料でサインアップ不要という敷居の低さがあるからこそ、気軽に検証できます。 このように、Perchance AI Image Generatorは「無料」「登録不要」「マルチモデル」「ブラウザ完結」という4つの価値を軸に、AI画像生成をより身近なものにするサービスです。セットアップの手間を省き、現在の気分や目的に合ったモデルを選べる柔軟性を備え、FAQやTutorialを活用すれば、プロンプト改善の tips and tricks も学びながら、より良い画像を作り上げられます。画像生成ツールを初めて使う人も、すでに有料サービスを利用している人も、まずはこの無料ワークスペースで実験してみることをおすすめします。
テキストから画像
Free
Pony Diffusion - Pony Diffusionで、ポニーアートを自由に、簡単に。 | Top 4 AI Tool loading
Pony Diffusionは、テキストの説明文(プロンプト)から高品質な非写実画像を生成するために設計された拡散モデルであり、その公式サイトは、モデルを誰でも簡単に体験できるエントリーポイントとして機能しています。ポニーをはじめ、動物、獣人、ファンタジーキャラクターなどを題材にしたイラスト生成に強みを持つ点が特徴で、アニメ調からリアルなタッチまで多彩なスタイルに対応します。サイトを開くと、まず目に飛び込んでくるのは、赤い髪の女性、リンゴを分け合うポニーガール、ロボットアームを装着したポニープリンセス、プレートアーマーを着たオーク戦士など、モデルの出力例です。これらの作例は、Pony Diffusionがどのようなビジュアルを生み出せるのかを直感的に示しており、初心者がワクワクしながら使い始めるきっかけを与えてくれます。公式サイトは「Ready to use」な体験を重視しており、面倒な環境設定を必要とせず、Playgroundにアクセスするだけですぐに生成を試せる設計です。 本サイトの説明は非常に丁寧で、What is Pony Diffusion? といった基本FAQ、How to Useの3ステップ、How Pony Diffusion Worksの技術解説、Key Featuresのまとめが一つのページに集約されています。この構成は、初めてAI画像生成に触れるユーザーにとって大きな安心感をもたらします。また、用語解説も分かりやすく、CLIPやscore_9のような専門概念がどのように生成品質に影響するかが理解できるため、単なるツール紹介を超えた学習リソースとしても価値があります。 Pony Diffusionの中心となるモデルは、約8万件のポニー画像とテキストペアのデータセットを使ってファインチューニングされています。また、CLIPモデルによる美的スコアリングを利用し、生成画像の品質を訓練段階から意識的に高めています。ユーザーはプロンプトにscore_9と入力するだけで、より洗練された画像を生成するようモデルを誘導できます。このプロンプトテクニックは、多くの生成モデルでも使われており、Pony Diffusionを学ぶことが他のAIアートツールの理解にもつながります。 サイト上には画像生成のコツが多数紹介されており、プロンプトの書き方から細部の指定方法まで、「tips and tricks」が体系的にまとめられています。特に、作品のテイストを変えたいときや、キャラクターの一貫性を保ちたいときに役立つノウハウは、実践的な価値が高いです。Web上の情報を活用すれば「more efficient」に試行錯誤できるため、初心者でも短時間で満足のいく作品に近づけます。また、上級者向けの「Tricks」も共有されています。例えば、特定のスタイルタグを組み合わせたり、プロンプトの単語順を変えたりすることで、作品の印象が大きく変わることがあります。どのタグが自分の作品コンセプトに合うかを実験しながら見つけていくプロセスは、ある意味で職人技とも言えます。自分にとって「most efficient」なプロンプト構成を確立できれば、アイデアを形にするスピードが飛躍的に向上するでしょう。 UIはシンプルで、テキストボックスにプロンプトを入れて実行するだけで画像が生成されます。専門的なコードを書く必要がないため、プログラミング経験がないユーザーでもすぐに使いこなせます。また、ローカル環境で実行したい技術者向けには、Hugging Face上でモデルが公開されており、PythonスクリプトやDiffusersライブラリを利用して高度なカスタマイズも可能です。つまり、手軽に試したいライトユーザーから、深く研究したいヘビーユーザーまで、それぞれのニーズに応じた利用方法を選べるのがPony Diffusionの強みです。 コミュニティ面では、DiscordやSNSで多くのユーザーが生成画像やプロンプトを共有し、互いにフィードバックを行っています。モデルの改善提案や新バージョンに関する情報も、こうしたコミュニティを起点に広がっています。実際、関連ツイートにはPony Diffusion V7とSD3に関するアップデートや、PixAIがPony Diffusion V6 XLをTrain LoRAのオプションモデルとして追加したというニュースが投稿されており、外部サービスとの連携も進んでいることが分かります。ライセンスはCreativeML OpenRAIL-Mで、無料で利用できるだけでなく、条件を守れば商用利用も可能です。オープンなAIモデルとして、多くのクリエイターの創作活動を支えているのです。 類似の画像生成AIと比較した場合、Pony Diffusionの独自性は、ポニーという特定テーマに深く特化している点と、コミュニティの力を活かした改良サイクルにあります。汎用モデルに比べて対象領域に特化しているため、ポニーやファンタジー系の表現力が高く、思い通りの作風を出しやすいのが特徴です。また、非写実的な画像に特化しているため、著作権や肖像権などの配慮が比較的しやすいというメリットもあります。商用利用を検討する際も、ライセンス条項を確認し、適切な使い方をすることで、安心してプロジェクトに組み込むことができます。 公式サイトでは、モデル本体の利用だけでなく、ブログやPony Realismといった関連リソースも提供されています。Pony Realismを利用すれば、より写実的なテイストのポニー画像生成を試すこともでき、同じ世界観の中で異なる表現を楽しめます。サイトは多言語に対応しており、英語だけでなく日本語を含む複数の言語で情報を取得できるため、世界中のユーザーが母国語に近い形で利用できます。これは、国境を越えたクリエイティブコミュニティの形成を後押しする大きなポイントです。 Pony Diffusionのターゲットユーザーは、まずポニーやアニマルキャラクターが好きなイラストファンです。また、同人誌やゲーム、VTuberコンテンツを制作するクリエイターにも適しています。さらに、AI技術や機械学習の研究者、生成AIをビジネスに取り入れたいマーケターも、手軽に使える強力なツールとして評価できます。特別な設備がなくてもWebブラウザで利用できるため、パソコンに詳しくない人でも安心して始められます。 今後、モデルの改良や新バージョンの登場に伴い、生成できる表現の幅はさらに広がると期待されます。コミュニティによるデータセットの充実やプロンプト技術の進化により、より細かな指示を反映した画像生成が可能になるでしょう。Pony Diffusionは、AIアートの民主化を象徴するツールの一つであり、誰もが自由に創造性を発揮できる環境を提供し続けています。 このように、Pony Diffusionとその公式サイトは、「Ready to use」な体験、学びやすい情報設計、自由度の高いオープンソースモデル、活発なコミュニティ活動を備えた、総合的なAIイラスト生成プラットフォームです。ポニーアートに興味がある人、生成AIを仕事に活用したい人、技術を深く学びたい人など、あらゆるユーザーが自分に合った形で活用できるツールとなっています。まずはPlaygroundでプロンプトを一つ入力してみてください。きっと、あなただけの素晴らしい一枚が生まれるはずです。
テキストから画像
Free
Pixal3D - 画像をそのまま3Dに。ピクセル精度のアセット生成を実現 | Top 4 AI Tool loading
Pixal3Dは、2D画像からピクセルレベルの忠実度を持つ高精細な3Dアセットを数秒で生成できる、次世代のImage-to-3D変換プラットフォームです。従来のAIによる3D生成技術では、画像をいったん「正準空間」と呼ばれる一般的なポーズに変換してから形状を推定するため、正面のデザインが崩れたり、細部がAIの幻覚(ハルシネーション)によって勝手に書き換えられたりする問題がありました。しかしPixal3Dは、画像のピクセル特徴をそのまま3D空間に逆投影する「ピクセルバックプロジェクション」という独自の手法を採用。元の2Dデザインと3D形状の間に直接的な対応関係を確立し、再構成と呼べるレベルの忠実度を実現しました。これにより、コンセプトアートやデザイン画が持つ正確なプロポーション、シルエット、細部の装飾まで、ほぼそのまま立体物として復元できます。 Pixal3Dのもう一つの強みは、複数視点の画像を利用できることです。1枚のラフなスケッチだけでなく、キャラクターのターンアラウンドや複数アングルの撮影画像を入力すると、それぞれから抽出した2D特徴量を3Dボリュームへ統合します。このマルチビュー集約によって、オクルージョン(隠れて見えない部分)も合理的に補完され、360度どの角度から見ても破綻の少ないモデルが生成されます。ゲームキャラクターやプロップの制作では、この機能だけで手戻りが大幅に減るはずです。 さらに、Pixal3Dは単一オブジェクトの生成に留まりません。モジュラーパイプラインを備えており、複数のオブジェクトが写った複雑なシーン画像を解析し、オブジェクトごとに分離された高忠実度の3Dシーンとして再構築することができます。環境デザインのラフ画から、背景用プロップを個別に取り出してレイアウトを組み直すといった使い方も可能です。 技術的な基盤としては、Tsinghua大学とTencentARCの研究チームによって開発され、SIGGRAPH 2026で発表された最先端の研究成果が反映されています。最新のオープンソース実装では、高性能なTrellis.2バックボーンを採用しており、推論速度と品質の両立を実現。コードはGitHubで公開され、Hugging Face上にはブラウザから気軽に試せるGradioデモも用意されています。ローカル環境での実行にはある程度のGPUが推奨されますが、デモを試すだけなら特別な環境構築は不要です。 サイトのポジショニングとしては、単なるAI玩具ではなく「プロダクションで使える3Dアセット生成ツール」に焦点を当てている点が特徴です。出力されるGLBファイルは、すぐに使える状態で提供され、PBRマテリアルが含まれているため、Unity、Unreal Engine、Blenderなどの主要なDCCツールやゲームエンジンへシームレスに統合できます。従来のように、生成後にトポロジー修正やテクスチャ再ペイントを何時間も行う必要がなくなります。 ターゲットオーディエンスは多岐にわたります。第一に、ゲーム制作スタジオに所属する3Dアーティスト。第二に、UnityやUnreal Engineを使うゲーム開発者。第三に、VRChatなどメタバース向けアバターを制作する個人クリエイター。第四に、AI生成モデルの研究開発に携わる研究者。第五に、映像や広告のプロダクションでビジュアル開発を行うデザイナー。第六に、高速プロトタイピングを求めるインディーゲーム開発者です。 コア機能としては、(1) シングルイメージ・マルチイメージ入力、(2) ピクセルバックプロジェクションによる高忠実度再構成、(3) PBRテクスチャ自動生成、(4) GLB形式エクスポート、(5) マルチビュー集約による360度品質向上、(6) モジュラーシーン合成、(7) Trellis.2をベースにした高速推論、(8) オープンソースでの公開、が挙げられます。 ユーザー体験は、ブラウザ上のデモから始められるのが最大の魅力です。特別なインストールは不要で、画像をアップロードして生成ボタンを押すだけ。UIは直感的で、初めてのユーザーでも迷うことなく3Dアセットを手に入れられます。生成結果はプレビューで確認でき、気に入らなければパラメータを調整して再生成することも可能です。 技術的な詳細を見ると、ピクセルバックプロジェクションは単なるアテンション機構ではなく、マルチスケールの2D特徴を3Dフィーチャーボリュームへ直接マッピングします。そのため、空間的な対応関係が非常に明快で、AIによる「それらしい形状」の生成ではなく、「元画像に存在する情報」の復元に近い動作をします。これは、学術的にも実務的にも大きなアドバンテージです。 料金は現時点では無料で、クレジットカード登録は不要です。Hugging FaceのGradioデモを利用すれば、Webブラウザ上で即座に体験できます。さらにGitHubリポジトリからコードを取得すれば、ローカル環境でのカスタム推論も可能です。商用利用を検討しているチームにとっても、導入ハードルが低い設計となっています。 総じて、Pixal3Dは「2Dの意図を忠実に3Dへ持ち込む」という課題を解決する、新世代の3D生成プラットフォームです。ゲーム、映像、メタバース、研究など、あらゆる3Dコンテンツ制作の現場で、より効率的なパイプラインを構築するための強力な選択肢となるでしょう。
画像から3Dモデル
Free
Yevideo AI - 多様なAIモデルを統合した、オールインワンの動画・画像生成プラットフォーム | Top 4 AI Tool loading
## Yevideo(イービデオ)とは:超効率的なAI動画・画像生成の統合プラットフォーム Yevideoは、複数の最先端AIモデルを一つの使いやすいインターフェースに統合した、オールインワンのAI動画・画像作成プラットフォームです。従来、高品質なAI動画や画像を生成するためには、それぞれ異なる専門ツールを使い分け、複雑な設定や環境構築が必要でした。Yevideoはそのような煩わしさからユーザーを解放し、アイデアの具現化から最終成果物までのプロセスを、驚くほどシームレスかつ直感的にします。 ### ウェブサイトのポジショニング Yevideoのポジショニングは、「創造性を最大限に引き出すための、統合型AIクリエイティブスタジオ」です。特定のAIモデルプロバイダーに依存するのではなく、Google(Veo 3.1シリーズ)、ByteDance(Seedance 2.0)、Kuaishou(Kling 2.6 / 3.0)、Alibaba(Wan 2.5 / 2.7)など、世界トップクラスのAIモデルを厳選し、プラットフォーム上で自由に選択・切り替えながら利用できる点が最大の強みです。これにより、ユーザーは「このツールではできない」という制限から解放され、プロジェクトの目的や求めるクオリティに応じて最適なモデルを選ぶことができます。 ### ターゲットオーディエンス 主なターゲットは、以下のような「効率的で高品質なビジュアルコンテンツ作成」を必要とする全てのクリエイターやビジネスパーソンです。 - **マーケティング担当者**: 広告用の動画やソーシャルメディア用の画像を、短期間かつ低コストで大量に生成したい方。 - **コンテンツクリエイター(YouTuber、TikToker)**: 魅力的なサムネイルや動画の一部分をAIで効率的に作成し、制作工数を削減したい方。 - **デザイナー**: コンセプトアートやモックアップの初期案を素早く生成したり、画像のスタイル変換や修正にAIを活用したい方。 - **スタートアップのプロダクトマネージャー**: 製品のプロモーションビデオやデモ動画を、専門家に依頼せずに内製化したい方。 - **個人の趣味人**: 最新のAI技術を使って、自分のアイデアを形にすることに楽しみを見出すテクノロジー愛好家。 ### 中核的な機能 Yevideoは、単なるモデル提供に留まらず、実際のクリエイティブワークフローを強力にサポートする多様な機能を備えています。 1. **多彩な生成モード**: テキストから画像(Text-to-Image)、画像から画像(Image-to-Image)、テキストから動画(Text-to-Video)、画像から動画(Image-to-Video)、動画から動画(Video-to-Video)など、あらゆる生成パターンをカバーしています。これにより、例えば「文章でイメージを起こし、それを元に画像を生成、さらにその画像を動かして動画にする」といった、一貫したワークフローが実現できます。 2. **強力な動画編集機能(AI Video Editor)**: 既存の動画に対してAIを使って編集を加えることができます。被写体の一部を置き換えたり、シーンの照明や雰囲気を変更したり(例:晴れのシーンを雨のシーンに)、指示を出すだけで思い通りの編集が可能です。 3. **高度な制御機能**: 多くのモデルで、動画の最初と最後のフレームを指定する「First/Last-Frame Control」や、カメラワーク(プッシュ/プル/パン/チルト)を細かく制御する「Camera Motion Control」、他の動画のモーションを転写する「Motion Imitation」など、プロフェッショナルな制作現場でも通用する高度な制御機能を提供しています。 4. **充実したInspirationギャラリー**: 他のユーザーが作成した作品や、各モデルのサンプル動画・画像を閲覧できます。これにより、自身のプロジェクトにおけるアイデア出しや、各モデルの得意分野を直感的に理解することができます。 ### コンテンツの特徴 このプラットフォームの大きな魅力は、**各AIモデルの「得意分野」を明確に表示している**点です。単にモデル名を羅列するのではなく、「高速生成向き」「高品質なカメラワーク」「優れたモーション転写」「強い文字レンダリング」といった具体的な強みを、モデルカードで簡潔に説明しています。これは、多様なモデルの中からユーザーが自分の目的に最適なものを迷わず選べるようにするための、緻密な設計です。 ### ユーザーエクスペリエンス Yevideoは、「Ready to use」な状態を最重要視しています。アカウント登録後、すぐにクレジットを付与され、特別な設定や知識がなくても各モデルを試すことができます。UIは洗練されており、生成モードの切り替えやモデルの選択もドロップダウンメニューから簡単に行えます。また、FAQのセクションでは、モデルの選び方やクレジットシステムについて丁寧に解説されており、初心者でも安心して使い始められる設計になっています。さらに、有料プラン(サブスクリプション)のユーザーは生成物を商用利用できるため、ビジネスシーンでの活用も強く後押ししています。 ### 技術的特徴 裏側では、Google、OpenAI、Black Forest Labs、ByteDance、Kuaishou、Alibabaといった複数のトップテクノロジーカンパニーのAPIを統合しています。Yevideoは、これらのAPIをラップし、一貫した料金体系と使いやすいインターフェースで提供することに注力しています。提供されるモデルは常に最新のものが優先され、「Gemini Omni Video」や「Seedance 2.0」などの最新モデルが「New」や「Hot」タグとともに紹介され、ユーザーが常に最先端の技術に触れられるようになっています。 このようにYevideoは、**Simplified**な操作性と**Integrated**されたモデルラインナップにより、AI動画・画像生成の敷居を劇的に下げ、創造性の発揮に集中できる環境を提供する、まさに**Intuitive**なクリエイティブプラットフォームです。 Yevideoで、あなたのアイデアを、超効率的なワークフローで現実のものにしませんか?
AIビデオジェネレーター
Freemium
Meme Picture - 顔写真を入れて、すぐ共有できるミーム画像を | Top 4 AI Tool loading
Meme Picture(ミームピクチャー)は、顔写真やペットの画像をアップロードするだけで、誰でもすぐに使えるミーム画像を生成できるオンラインサービスです。従来の画像編集ソフトとは異なり、Photoshopやデザインスキルは一切不要で、ブラウザを開いて数ステップを踏むだけで完了します。ログインなしで1日3回の無料生成が可能で、クレジットカードの登録も必要ありません。 このサービスは、インターネット上で親しまれている定番のミームテンプレートに自分の顔やペットの顔を自然に合成し、チャットやSNSですぐに共有できるPNG画像を書き出します。生成にかかる時間は平均約30秒。1回の実行で2〜4枚の候補が提示されるため、最も面白い1枚を選んでダウンロードできます。カートゥーン、ピクセルアート、手描き、リアルといった視覚スタイルを選べるので、元の写真の雰囲気を保ちながらミームの世界観に合わせた仕上がりを楽しめます。 Meme Pictureの最大の特長は、従来の「テンプレートに文字を重ねるだけ」のミーム作成ツールではなく、顔そのものをミームの登場人物として合成する点です。つまり、Distracted BoyfriendやWoman Yelling at Cat、Drake Hotline Bling、Surprised Pikachu、This Is Fine、Change My Mind、One Does Not Simply、Success Kidといった定番フォーマットの中に、自分の表情やペットのかわいい顔が自然に入り込みます。これにより、友人とのグループチャットやSNSで共有したときに、単なるテキスト付き画像よりもはるかにパーソナルで笑える反応が生まれます。 利用の流れは極めて直感的です。まず自分またはペットの写真をアップロードします。JPEG、PNG、WebP形式に対応しており、最大4MBまで、大きな写真は自動圧縮されます。次に好みのミームテンプレートを選択し、必要に応じてキャプションや追加の指示を入力します。続いて視覚スタイルを選び、「Generate memes」をクリックすると、同じページ内に結果が表示されます。ログインせずに試せるサンプル写真も用意されているため、手元に適切な写真がなくてもすぐに操作感を確かめられます。 この一連の体験は、より効率的なミーム作成を求めるユーザーにとって理想的な設計です。Photoshopで顔を切り抜き、色調を調整し、レイヤーを重ねて書き出す作業は、慣れた人でも20〜45分かかります。Meme Pictureはその工程を自動化し、約30秒で候補を提示します。テンプレートごとに専用ページが用意されており、キャプション例や歴史、よくある質問も確認できるため、初めての人でも迷わずに使い始められます。 Meme Pictureは無料利用から始められるFreemiumモデルを採用しています。無料プランでは1日3回、毎回2候補、ウォーターマーク付きの生成が可能です。より多くのミームを作りたいヘビーユーザー向けに、月額9.99ドルのProプランでは1日最大30回、毎回4候補、ウォーターマークなし、GIFミーム、HD書き出し、クラウド履歴が提供されます。年間契約なら79.99ドルで33%割引になります。さらに、日次無料枠を使い切った後でも利用できる買い切りの生成パックも用意されており、10回分が2.99ドル、30回分が6.99ドルです。 プライバシーへの配慮もMeme Pictureの重要な柱です。アップロードされた元の写真は生成後に削除され、ログインしたユーザーが保持するのは完成したミーム画像のみです。運営側は写真をAIの学習に使用したり、第三者に販売したりしません。この点は、顔写真を扱うサービスにおいて安心感を与えます。特に日本のユーザーは個人情報の取り扱いに敏感な傾向があるため、このポリシーは大きな信頼材料になります。 ターゲットオーディエンスは多岐にわたります。毎日のようにSNSへ投稿する個人ユーザー、DiscordやSlackでリアクション画像を多用するコミュニティ参加者、ペットの写真を家族や友人と共有したい飼い主、デザインスキルを持たないマーケター、内輪ネタを手早く作りたい学生、ゲーム配信やVTuber活動で視聴者と交流する配信者、社内コミュニケーションを和ませたいチームなどが代表例です。いずれも「手軽に、面白く、パーソナルな画像を作りたい」という共通のニーズを持っています。 コンテンツ面では、15種類以上のクラシックなミームテンプレートが厳選されています。Distracted Boyfriendは新しいものに目を奪われたとき、Woman Yelling at Catは口論や指摘、Drake Hotline Blingは二つの選択肢の比較、Surprised Pikachuは予想通りの結末への驚き、This Is Fineは混沌の中での平静、Change My Mindは大胆な意見の提示、One Does Not Simplyは不可能な状況、Success Kidは小さな勝利を表現します。これらのテンプレートはすべて、SNSやチャットで広く認識されているレイアウトを保っているため、言葉による説明がなくても文脈が伝わります。 ユーザーエクスペリエンスの面では、複雑なメニューや設定画面がなく、トップページから直接生成画面へ進めます。アップロード、テンプレート選択、スタイル選択、キャプション入力、生成までが単一のページにまとまっており、スクロールするだけで操作が完結します。スマートフォンとデスクトップの両方のブラウザに対応しており、端末を問わず同じ品質で利用できます。書き出されるPNGはWhatsApp、Discord、Telegram、WeChat、iMessageなどへの即時共有に最適化されています。 技術的特徴としては、Meme PictureはGPT Image 2を基盤としており、OpenAIとは独立したプロダクトであると明記されています。画像アップロード時の自動圧縮、顔配置とスタイル変換の自動処理、PNGエクスポート、GIF生成(Pro)などが実装されています。クラウド履歴機能はProユーザー向けに提供され、過去の生成結果を振り返ることができます。無料ユーザーでも、生成結果はページ内に表示され、すぐに保存できます。 競合との違いも明確です。ImgflipやCanvaはストック画像へのキャプション重ね合わせに強みがありますが、Meme Pictureは「自分の顔をミームに入れる」ワークフローに特化しています。自分のセルフィーやペットがリアクションそのものになるため、汎用テンプレートにテキストを載せるだけよりもはるかに没入感があります。無料の日次枠があり、Proではウォーターマーク除去やHD書き出し、GIF対応などが加わるため、用途に応じて段階的にアップグレードできます。 日本市場へのローカライズも意識されています。日本語のインターフェースが提供され、ミーム文化に馴染みのないユーザーでもガイドやFAQを通じて理解を深められます。日本のチャット文化ではスタンプやリアクション画像が日常的に使われるため、自分の顔入りミームはLINEやX(旧Twitter)、Instagramなどで特に受け入れられやすいでしょう。Meme Pictureは「自分がミームになる」という体験を、手間なく、楽しく、安全に提供します。 総合すると、Meme Pictureは、すぐに使えるミーム生成、より効率的な顔合成、便利な無料枠、直感的な操作性、シームレスな共有体験を兼ね備えたサービスです。写真さえあれば誰でも数秒で笑えるコンテンツを作れ、デザイン知識も高度な編集技術も不要です。SNSでのエンゲージメント向上、友人とのコミュニケーション促進、ペット自慢、チームの雰囲気づくりなど、幅広い場面で活用できます。無料で試せるため、まずは一度顔写真をアップロードして、AIが生み出す自分だけのミーム画像を体験してみることをおすすめします。
AI顔交換ジェネレーター
Freemium
Kirkify - AIで顔をCharlie Kirkに変えるフェイススワップ | Top 4 AI Tool loading
Kirkify(カークファイ)は、あらゆる顔写真をCharlie Kirk氏の象徴的な表情に変換する、Ready to use(すぐに使える)AIフェイススワップ・プラットフォームです。近年、TikTokやXを中心に爆発的に流行している「Kirkification(カーク化)」と呼ばれるミーム文化を、誰でも手軽に体験できるように設計されています。本サイトは、複雑な画像編集ソフトや専門知識を一切必要とせず、ブラウザ上で写真をアップロードするだけで、数秒から数十秒のうちに完成度の高いカーク化画像を生成します。初回は無料クレジットが付与され、クレジットカードの登録も不要なため、気軽に試せる点が大きな魅力です。Kirkifyは、単なる顔変換ツールにとどまらず、ソーシャルメディア時代の即時性とユーモアを追求したエンターテインメント・プラットフォームとして位置づけられます。 Kirkifyの最大の特徴は、その圧倒的な手軽さと一貫性です。ユーザーは、JPG、PNG、WEBP形式の画像(最大8MB)をワークスペースにドラッグ&ドロップするだけで、AIが自動的に顔を検出し、Charlie Kirkの参照画像に基づいて顔を置き換えます。この一貫した参照基準により、どのような写真でも常に同じ仕上がりが得られ、ミームとしての認識性が保たれます。処理は通常30秒以内に完了し、進捗状況がリアルタイムで表示されるため、待ち時間のストレスも最小限に抑えられています。また、複数の顔を一括で変換できる「Multiple Faces」モードも用意されており、グループ写真や集合写真の加工にも最適です。出力は高画質のPNG形式でダウンロードでき、共有リンクをコピーしてSNSへ直接投稿することも可能です。 Kirkifyの対象ユーザーは多岐にわたります。まず、ソーシャルメディアでバイラルミームを制作・拡散したいミームクリエイターにとって、Kirkifyは欠かせないツールです。TikTokやXでトレンドに参加したい動画投稿者も、Kirkifyで作成した画像を素材として短時間でコンテンツを量産できます。友人とのグループ写真を面白く加工してグループチャットで共有したい一般ユーザーにも、登録不要の手軽さが受け入れられています。さらに、政治風刺やジョークコンテンツを楽しむコメディファン、ブログやウェブサイトのアイキャッチ画像を制作するブロガー、画像編集ソフトが苦手な初心者、バイラルマーケティングを企画するSNS担当者など、幅広い層に利用されています。Kirkifyは、技術的なスキルや年齢を問わず、誰もが笑いを生み出せる場を提供しています。 Kirkifyの主要機能は、洗練されたAIフェイススワップ技術に支えられています。画像内の顔を正確に検出し、Charlie Kirkの特徴的な顔立ちへと変換するプロセスは、Replicateがホストする顔スワップモデルによって実現されています。これにより、写真の構図や照明を保ちながら、顔の部分だけを自然に置き換えることができます。特に、複数顔の一括処理機能は、一枚の画像に写るすべての人物を同時にKirk化できるため、作業効率が格段に向上します。ファイル形式はJPG、PNG、WEBPに対応し、出力はPNG形式で提供されるため、画質の劣化が少なく、印刷や編集にも適しています。また、無料キューを利用すれば、追加料金なしで処理を待つことも可能です。 Kirkifyのコンテンツ面での魅力は、豊富なギャラリーとショーケースにあります。サイト内には、実際にユーザーが作成したKirkified画像が多数掲載されており、新規ユーザーはそれらを参考にすることで、自分なりのミーム制作のヒントを得ることができます。さらに、使い方のチュートリアルやブログ記事も充実しており、Kirkificationのトレンド解説や効果的な投稿方法など、tips and tricksが紹介されています。これらのコンテンツは、初心者がつまずきやすいポイントを解消し、より効率的にミーム作成を楽しむためのサポートとして機能しています。また、AIビデオ生成ツールとの連携も提供されており、静止画だけでなく動画コンテンツへの展開も可能です。 ユーザーエクスペリエンスの観点では、Kirkifyのインターフェースは直感的で、初めて訪れた人でも迷うことなく操作できるよう設計されています。ホームページのワークスペースには、画像のアップロードエリアが大きく表示され、ドラッグ&ドロップまたはクリックでファイルを選択できます。Kirkifyモードの選択、変換の実行、結果のダウンロードまで、すべてのステップがシンプルに整理されています。アカウント登録が不要であるため、面倒な個人情報の入力やパスワード管理から解放され、すぐに使い始めることができます。また、モバイル端末からのアクセスにも対応しており、スマートフォンで撮影した写真をその場で変換できる点も高く評価されています。 技術的な側面では、KirkifyはReplicateが提供する顔スワップモデルを活用することで、安定した品質と高速な処理を両立しています。単一の参照画像を基準とすることで、すべての出力が一貫したCharlie Kirkの外見に統一され、ミームとしての視認性が保たれます。これにより、複数の画像を使ったシリーズ作品でも統一感を損なうことがありません。また、8MBまでのファイルサイズに対応しているため、一般的なスマートフォンやデジタルカメラで撮影した写真をそのまま利用できます。セキュリティ面では、アップロードされた画像は変換処理にのみ使用され、必要以上に保存されない設計が期待されますが、利用前にプライバシーポリシーを確認することをお勧めします。 料金体系はフリーミアムモデルを採用しており、新規ユーザーには1回分の無料クレジットが付与されます。無料クレジットを使い切った後も、無料キューを利用して追加の変換を行うことが可能ですが、混雑時には待ち時間が発生する場合があります。より迅速かつ優先的に処理を行いたいユーザー向けに、追加クレジットの購入オプションが用意されており、2クレジット単位などで購入できます。この従量制の仕組みは、頻繁に利用するヘビーユーザーから、たまに楽しみたいライトユーザーまで、それぞれのニーズに柔軟に対応しています。また、商用利用を検討する場合は、利用規約と各プラットフォームの規則を確認することが推奨されます。 文化的・社会的な観点から見ると、Kirkifyは現代のインターネットミーム文化を象徴するツールと言えます。Charlie Kirkという特定の人物を題材にした風刺的なコンテンツは、TikTokやXなどのプラットフォームで瞬く間に拡散され、多くのユーザーが参加するトレンドとなっています。Kirkifyは、そのトレンドに誰でも簡単に参加できる入り口を提供することで、ユーザー生成コンテンツの創造性を刺激しています。同時に、AI生成コンテンツであることを明示し、各プラットフォームのガイドラインに従うことの重要性もサイト内で案内されており、責任ある利用が促されています。 Kirkifyをより効率的に活用するためには、いくつかのコツがあります。まず、画像は顔がはっきりと写っているものを選ぶと、変換精度が向上します。また、複数人で写っている写真を一括処理する場合は、「Multiple Faces」モードを選択することで作業時間を大幅に短縮できます。さらに、無料キューが混雑している時間帯を避け、追加クレジットを利用することで、より快適な体験が得られるでしょう。これらのちょっとしたTricksを押さえることで、Kirkifyはmost efficientなミーム制作ツールとして、その真価を発揮します。Kirkifyは、笑いと創造性を求めるすべての人にとって、今最も注目すべきAIツールの一つです。
写真と画像エディター
Freemium
LogoAI - AIでプロ並みのロゴを数秒で作成 | Top 4 AI Tool loading
LogoAIは、現代のビジネス向けに設計されたAI搭載のオンラインロゴ作成プラットフォームです。このサービスは、プロのデザイナーに依頼する時間とコストをかけずに、すぐに使える高品質なロゴを誰でも作成できることを目指しています。LogoAIの中心には、Smart Logo Architectと呼ばれる高度なAIエンジンがあり、ユーザーが入力したブランド名、業界、デザインの好みを分析して、スケーラブルで印刷対応、かつブランドに完全にマッチしたロゴを自動生成します。 本サービスの特徴は、単なるロゴ作成にとどまりません。ロゴフォント生成、ブランドカラーパレットAI、タイポグラフィデザイナーを含むComplete Brand Kitを提供し、ユーザーはロゴだけでなく、一貫性のあるブランドアイデンティティ全体を構築できます。また、SVGロゴ書き出し、透過PNG、高解像度ベクターファイルなど複数の形式で即座にダウンロードできるため、名刺やウェブサイト、SNS、印刷物などあらゆる用途に適しています。 LogoAIの最大の強みは、より効率的なデザインプロセスです。従来のロゴ制作では、デザイナーとの打ち合わせ、複数回の修正、数日から数週間の待機が必要でした。しかしLogoAIでは、Instant Logo Designプロセスにより、60秒以内に6つの独自コンセプトを同時生成します。ユーザーはそれらを比較し、最もブランドを表現しているものを選択し、必要に応じてAI画像エディターで色、フォント、アイコン、レイアウトを直感的に微調整するだけで完了します。 この自動化されたワークフローは、デザイン経験のないユーザーに特に便利です。LogoAIのインターフェースは、すべてのスキルレベルを想定して設計されており、複雑な操作を学ぶ必要はありません。いくつかの簡単な質問に答えるだけで、AIが複雑なデザイン作業を肩代わりします。そのため、初めてロゴを作る起業家や、時間のない中小企業経営者でも、迷うことなくプロ品質の結果を得られます。 さらに、LogoAIはプロフェッショナル品質にもこだわっています。生成されるロゴは、拡大しても輪郭がくっきりと表示されるベクター形式に対応しており、名刺のような小さな媒体から看板のような大きな媒体まで、あらゆるサイズで鮮明さを保ちます。印刷対応のカラーモードや、Web用のRGB形式にも適切に対応しているため、オフラインとオンラインの両方で一貫したブランド体験を提供できます。 スタイルの面でも、LogoAIは豊富な選択肢を用意しています。ユーザーは、ミニマリスト、テック、ラグジュアリー、レトロ、抽象、幾何学など、厳選されたスタイルコレクションからインスピレーションを得られます。これにより、業界やブランドの個性に合わせて、最適なトーンと雰囲気を簡単に見つけることができます。たとえば、テクノロジー企業にはモダンで洗練されたテックスタイル、高級ブランドにはプレミアムでエレガントなラグジュアリースタイルが適しています。 ユーザー体験もLogoAIの重要な要素です。ページを開いてからロゴをダウンロードするまで、無駄なステップはありません。明確な3ステップのガイド、つまりブランド詳細の入力、候補の生成と選択、ダウンロードとローンチが表示され、初回来訪者でも迷わず進めます。また、FAQセクションでは、無料プランの内容、デザインスキルの要否、ベクター形式のダウンロード可否、作成時間、ダウンロード後の編集可能性など、よくある疑問に簡潔に答えています。 技術的な特徴としては、LogoAIは最先端のAI画像生成および編集技術を統合しています。AIロゴジェネレーターは、ブランド名と業界情報から意味的に関連するアイコン、形状、色彩を分析し、独自性の高いデザインを生み出します。さらに、AI画像エディターは、ユーザーが選択したロゴをピクセル単位で調整できる機能を提供し、直感的な操作でレイアウトや配色を洗練できます。 技術的な観点では、LogoAIはスケーラブルなベクターグラフィックスを生成するため、SVG形式での書き出しに対応しています。これにより、ユーザーはロゴをAdobe IllustratorやFigmaなどのプロフェッショナルツールでさらに編集したり、印刷所に入稿したりすることが可能です。透過PNG形式も用意されているため、ウェブサイトのヘッダーや動画のウォーターマークなど、背景を選ばずに配置できます。 また、LogoAIは色彩理論とタイポグラフィのベストプラクティスをAIに学習させており、生成されるロゴは視認性と美的バランスを保っています。ブランドカラーパレットAIは、選択したロゴに調和する配色を自動提案し、ロゴフォントジェネレーターはブランドのトーンに合った書体を推奨します。これにより、ユーザーはデザインの専門知識なしでも、ブランド全体で統一感のあるビジュアルを実現できます。 料金体系はフリーミアムモデルを採用しており、基本的なロゴ生成と高品質ダウンロードは無料で利用できます。プレミアムにアップグレードすると、高度な編集機能やブランドキットのダウンロードなど、さらに幅広い機能を利用できます。この柔軟な料金体系により、予算の限られた個人から、本格的なブランド構築を求める企業まで、幅広いユーザーに対応しています。 LogoAIが対象とするユーザー層は非常に多様です。起業家やスタートアップ創業者は、初期段階のブランドロゴを迅速に用意できます。中小企業経営者や個人事業主は、低コストでプロ品質のロゴを手に入れ、販促物や名刺に活用できます。フリーランスデザイナーやマーケターは、クライアント提案用のモックアップを効率的に作成し、最終調整に集中できます。オンラインショップ運営者は、商品画像やSNS広告に統一感のあるロゴを使用できます。さらに、ブロガー、YouTuber、コンテンツクリエイター、アプリ開発者、飲食店オーナー、非営利団体など、ブランドを持つあらゆる人々にとって有用です。 実際の利用シーンを考えると、その汎用性が際立ちます。たとえば、急なイベントやキャンペーンのために短期間でロゴが必要な場合でも、LogoAIなら数分で準備できます。また、既存のロゴに満足していない企業が、リブランディングの第一歩として新しいデザインの方向性を探る際にも役立ちます。さらに、複数のブランドやプロジェクトを抱えるユーザーは、各プロジェクトに合わせて異なるスタイルのロゴを一元的に作成・管理できます。 LogoAIのサイトには、ロゴ作成への導線としてStart CreatingやDesign Logo in Secondsといった明確なCTAが配置され、ユーザーを迷わせません。また、フッターにはAIロゴジェネレーター、オンラインロゴメーカー、ロゴフォントジェネレーター、AI画像エディターなどの主要機能へのリンクが整理されており、目的のツールにすぐアクセスできます。さらに、Tech Logo InspirationやMinimalist Logo Ideasなど、スタイル別のインスピレーション情報も提供しています。 教育や非営利の分野でもLogoAIは活用されています。学生がイベントやクラブ活動のロゴを作成したり、NPOが寄付キャンペーンのビジュアルを準備したりする際に、無料プランが大きな助けになります。専門的なデザインソフトを購入する余裕がない団体でも、ブラウザ上で完結するため、環境を選ばず利用できます。 総合的に見て、LogoAIは、ロゴデザインを民主化し、誰もがブランドを構築できるようにするプラットフォームです。すぐに使える操作性、より効率的な自動生成プロセス、便利なブランドキット、直感的なエディター、自動化されたワークフローが一体となり、現代のビジネスが求めるスピードと品質を高い水準で両立しています。デザインの専門知識がなくても、あるいは予算が限られていても、プロフェッショナルなロゴを手に入れたいと考えるすべての人にとって、LogoAIは信頼できる選択肢となるでしょう。
AIデザインジェネレーター
Freemium

Frequently Asked Questions

What is MaoMaoYu Top4 AI Tools Directory?

Top 4 AI — '4' means 'For', MaoMaoYu Top For AI Tools Directory - top4ai.com is building an ai tools directory that helps you get your favorite ai tools, free ai tools list. It can get best ai writing tools, best free ai tools for writing articles, content at scale ai detector, best ai email marketing tools, ai paraphrasing tools, best ai seo tools, ai study tools, 'pearson' and 'ai' and 'study tools', ai generator tools, ai hashtags generator tools, best ai tools for research, ai art tools, ai music tools, ai video editing tools, ai pair coding tools, ai photo tools, ai tools for detecting photoshopped imagers, best ai tools for start up companies who are researching their market and more here.

How to found your ai tools in MaoMaoYu Top4 AI tools directory?

1. Open top4ai.com.

2. Explore the ai tools in the MaoMaoYu Top4 AI tools directory.

3. Click the ai tools that you need to get the detail and visit it.

What are the main features of MaoMaoYu Top4 AI Tools Directory?

1. Explore a simple definition of AI tools and discover how to fast find the perfect one for your needs. Streamline your workflow with the right AI solution.

2. Intelligent Search Engine: Thinking of what you think, saving you time, saving you trouble

Is it free to submit ai tools to MaoMaoYu Top4 AI Tools Directory?

Yes, it's free currently.

What's the categories list of AI Tools that MaoMaoYu Top4 AI Tools Directory support?

We will support all kinds of AI Tools later. Please wait for a few days.

What's the frequency for the up of AI tools in MaoMaoYu Top4 AI Directory?

The list of AI tools will be updated daily.

Is it support QuillBot, GPT-4o or Sora AI here?

You can get the QuillBot, GPT-4o or Sora AI tool here. Here is the introduction of GPT-4o and Sora video, and you can visit the website of the tools.

Troubleshooting

If the content aren't appearing, try a different browser, clear your cache. If issues persist, contact us at support@top4ai.com | support@maomaoyu.coffee.

What are the usage rights of the AI tools?

MaoMaoYu Top4 AI Tools Directory is just the AI Directory for AI tools. The usage rights of the AI tools are based on the AI tools' website.